每个孩子有自己的工作台,师徒之间只靠纸条往来。
Flashduty AI SRE 是一个专注 SRE 领域、帮你做故障根因分析、日常运维工作的 AI Agent 产品,注册即可免费试用。这是系列文章《Flashduty AI SRE 技术揭秘》第 4 篇,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。
系列导航:SRE Agent 架构与工程实践;相关实践:并行工具调用的安全切点、告警风暴下的分析扇入。
上一篇结尾留了个预告:这篇聊 multi-agent 里少有人写的细节。业界讲 multi-agent,讲的多是编排范式、协作模式;真把它做进产品,坑全在没人写的地方——子 agent 跑到一半想向父 agent 提问怎么办?父 agent 怎么知道自己还有几个孩子在跑?孩子的回答是"残的",系统怎么知道?
这篇讲我们在父子通信上做的四个设计,每个背后都有具体的翻车现场。
核心要点
- 子 Agent 的身份: 每个子任务是独立会话,通过异步消息和父会话通信,而不是一次同步工具调用。
- 结果怎么送达: 子任务先保存终态,再投递通知;失败后由后台补发,重复消息通过去重处理。
- 成本与边界: 连续的完成通知可以合批,但唤醒父会话仍有模型调用成本;当前设计只允许一层子 Agent 扇出。
孩子不是一次工具调用,是一个完整的会话
第一个决策:子 agent 不是父会话里的一次工具调用,而是一个独立的会话——有自己的消息队列、自己的 actor、自己的上下文,复用第一篇讲的那整套会话运行时。派发工具 agent_dispatch 是异步的:同步返回一个 task_id 和 async_launched 状态,结果稍后以通知的形式回来。
异步派发有个直观的失败模式,我们在第 3 篇提过:模型不知道"结果会自己回来",就原地空转等——真实审计里抓到过一个模型 busy-wait 时连续跑了 38 次 echo、14 次 date。第 3 篇讲的 dispatch checkpoint 是防御的一半:这一轮直接结束,不给它空转的机会。另一半在派发工具的返回值里:除了 task_id,还有一段明确的指引,告诉模型"不要轮询、不要等待,结果会以 <task-notification> 的形式回来,在那之前继续做别的或收尾"。checkpoint 管"停下来",指引管"停下来之前别作妖"。
孩子跑完一轮后,结果怎么回到父会话?走队列:子侧把终态先落库,再组一条通知消息 LPUSH 进父会话的队列,父的 actor 被唤醒后处理。顺序是先落库、后投递,且只有投递确认成功才标记"已通知";投递失败没关系,后台有一个 reconciler 定期扫库,发现"终态但没通知"的任务就从行状态重建通知重发。通知必须至少到达一次,重复由去重键吸收。
父被唤醒时,队头经常躺着好几条通知(十个孩子可能扎堆完成)。这里有一层合批:队头连续的通知合并成一条消息送给模型,省一轮一轮的唤醒成本。合批的规则简单到有点朴素:没有窗口、没有上限,就是"队头连续的通知形消息",遇到第一条非通知(比如真人消息)就停。但有一个例外是硬性的:子 agent 主动发给父的消息(提问、进展汇报)永远不参与合批——每个孩子的声音都是独立的一轮,不能被揉进别人的通知里。
还有一条容易做错的规则:本地子 agent"提问"的那一轮,不发完成通知。因为孩子提问时任务没结束,只是挂起等回答;此时发一条"完成"通知会把任务翻成终态,压在即将到来的回复上面。问题本身已经躺在父队列里了,安静等父回答即可。
上行消息限 2000 字符:父要为每个字符付钱
子给父发消息,我们定了一个上限:2000 个字符。
直觉上孩子的汇报越详细越好,证据链完整、过程清楚。这个直觉的问题在于:子 agent 发上来的每个字符,都要进父 agent 的上下文窗口,父要为它付 token 成本——而保护父的上下文窗口,恰恰是一开始派孩子出去的目的。一个孩子交上来三万字的完整排查过程,扇出就白做了。
所以上限的语义是:给孩子发消息的空间,不是给孩子写最终答案的空间。需要更多篇幅才能讲清楚的事,说明那是孩子的工作产物,应该落在文件里、把路径报上来,而不是塞进消息。
实现的几个细节:
- 按字符数算,不按字节。中文和英文同宽,不存在"写中文吃亏"的问题。
- 超限报错,不截断。截断是静默丢信息——孩子以为自己说完了,其实最关键的结论恰好被切掉。报错把"哪些值得说"的决定权留给最了解内容的一方,让它自己重写。报错文案也直说:发那个父 agent 能据此行动的发现,别发完整过程。
- 除了长度还有频率:每轮最多 5 条上行消息。但超了不报错,返回一个"限额已到"的状态让孩子继续干活——报错只会让它换个姿势重试。
别让父 agent 自己数孩子
父 agent 扇出五个孩子之后,一个自然的问题是:它怎么知道还有几个在跑?
直觉解法:让模型自己记。派的时候记着"5",每收到一条完成通知减一,减到零就总结。这个办法在演示里永远是对的,在生产里恰好会在最要紧的时候出错:孩子一多、唤醒次数一多、历史再被上下文压缩折叠过一轮,“派了几个减回来几个"这道算术就必错,而且两个方向都错——孩子还在跑就下了结论,或者孩子早回了还在干等。
这个数字,我们这边一次 DB 查询就有,模型那边却不可猜。所以答案就是:我们直接告诉它。每次父被通知唤醒,消息末尾附一行从库里查出来的实况:
<siblings running="2" awaiting-input="1" done="5"/>
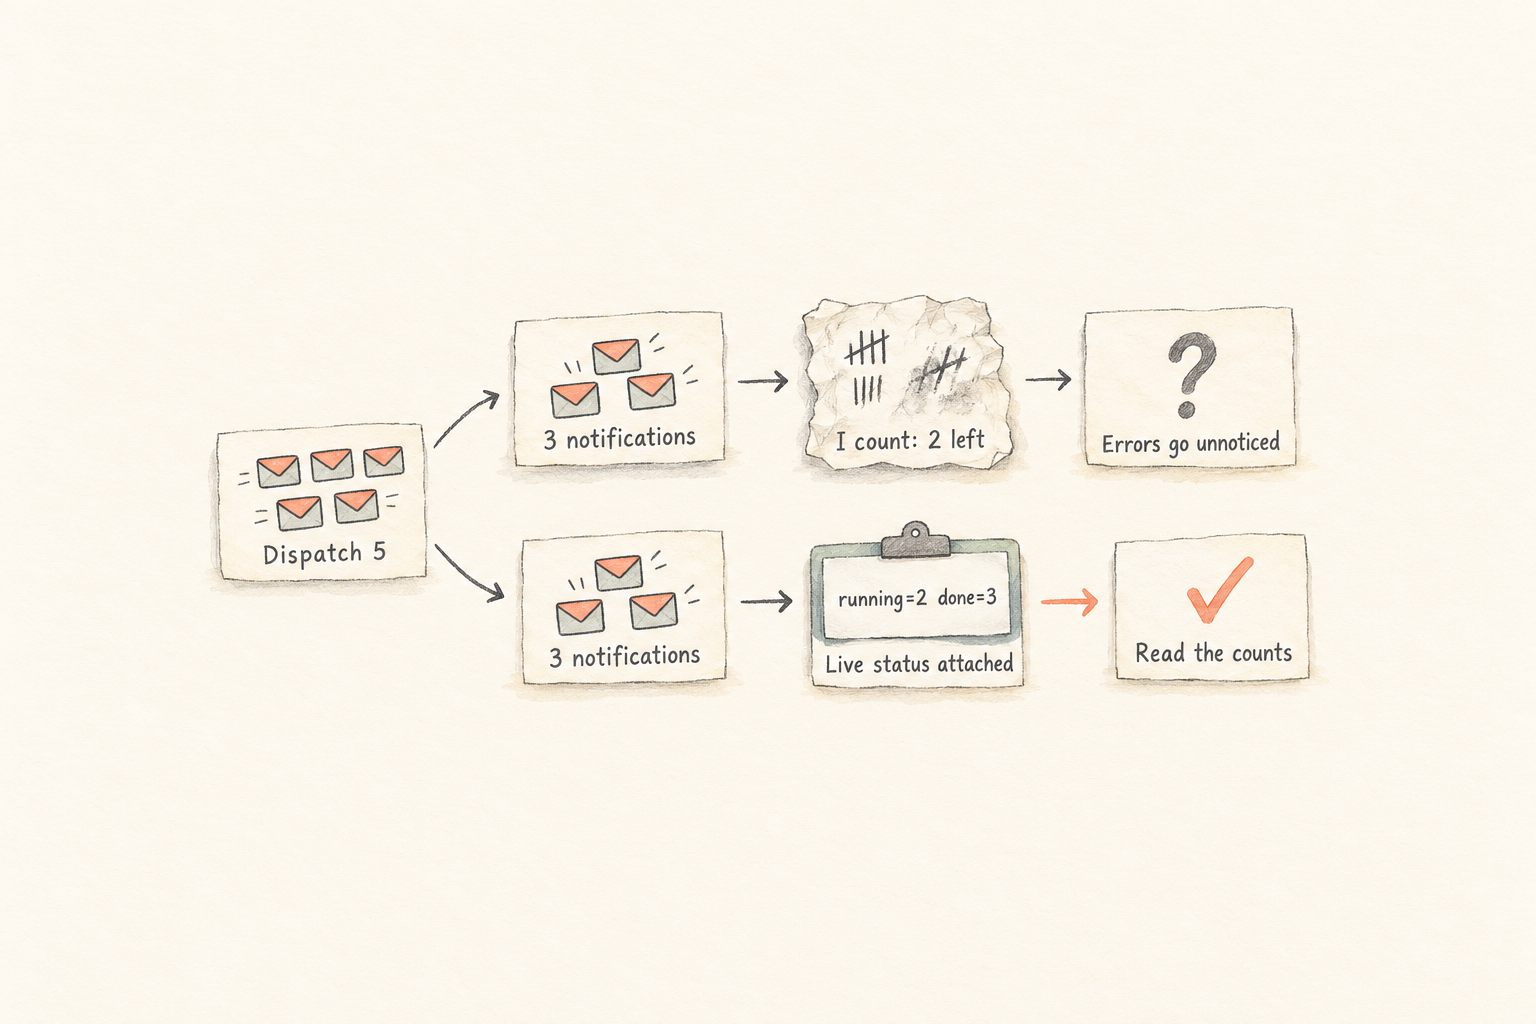
上:记忆减法在"孩子多、唤醒多、历史被折叠"时必错;下:每次唤醒附一行实况,不用算。
这行有个故意的偏执:看不懂的状态一律计入 running。终态计 done,等输入计 awaiting-input,剩下包括我们不认识的状态全算 running。多报的代价是父多等一会;少报的代价是父在孩子还在跑的时候就下了结论——后者就是这行存在的意义,所以宁可多报。DB 查不动的时候整行静默省略,不让一个辅助信息阻塞通知主链路。
“答案是残的"不能只是一句散文
最后一个坑在数据形态上。子 agent 的轮次可能没跑完自己的计划就被截断——撞上步数上限,或者重复同一批工具调用被防死循环的 guard 硬停。这时候它交回来的回答是部分结果。
以前,“这个答案是残的"这件事唯一的记录,是回答里的一句英文散文。散文 SQL 读不了、代码用不稳:想回答"我们多常截断子 agent、是哪个 guard 在切"这种问题,只能靠 grep。而这恰恰是判断"步数上限是不是定低了"“防死循环是不是太敏感"的输入数据。
修法是给任务表加了一列 truncated_reason:
step_limit:撞了 agent 自己声明的步数上限;loop_guard:同一批工具调用重复到被 guard 硬停;- 空串:正常跑完了自己的轮次。
几个设计选择:被截断的轮状态仍然是 completed,不新增任务状态——guard 会塞给模型一条合成的收尾消息,这轮确实是"完成"了;不加状态,状态机、前端、reconciler 就都不用动。每轮结束都写这列、包括写空串——被挂起再恢复的任务不会拖着上一轮的标记。这列和终态在同一次原子写入里落库,所以任何时刻去观察一行终态任务,标签都已经在场。通知块里也带上 <truncated> 子标签,reconciler 补发通知时从这列重建——补发的和当时活着的那条说同一件事。
从此"答案是残的"是一个 where 条件,不再是 grep 表达式。
取舍与边界
深度只有两层。 主 agent 能派孩子,孩子不能再派孙子——派发、停止任务这类工具在子会话里直接被裁剪掉,工具面按会话深度分流(同一个 agent_message 名字,深度 0 是"发给我的孩子”,深度 ≥1 是"发给派我出来的那个”,实现是两把不同的工具)。单层扇出的复杂度已经够写一篇文章了,嵌套扇出的收益我们还没看到。
父的"等待"是一连串唤醒。 异步架构里没有真正的阻塞等待:父每次被通知唤醒都是一轮新的模型调用,都有成本。孩子越多、回得越零散,父被唤醒的次数越多。合批缓解了这个成本,但没消除它。
等待不能没有兜底。 孩子向父提问后挂起,如果父那边出了意外永远没人回答,孩子不能挂到天荒地老:后台 sweeper 会把 30 分钟无人回答的提问置为失败。所有"挂起等外部事件"的设计都必须配一个超时回收,没有例外。
这篇讲的是父子之间怎么通信,下一篇回到上下文本身:所有 agent 系统都做压缩,但"压缩请求本身的成本"很少被讨论——我们怎么让 summarizer 蹭上主对话的 prompt cache。
这是 “Flashduty AI SRE技术揭秘” 系列的第四篇。我们在做一个专注 SRE 领域、帮你做故障根因分析的 AI Agent 产品,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。