停止请求先一步到达,在门口留了张字条;开工的人推门就能看到。
Flashduty AI SRE( https://www.flashduty.com ) 是一个专注 SRE 领域、帮你做故障根因分析、日常运维工作的 AI Agent 产品,注册即可免费试用。这是系列文章《Flashduty AI SRE 技术揭秘》第 2 篇,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。
上一篇聊了会话运行时:每个会话一个"专职管家",Redis 一把锁保证同一时刻只有一个管家在服务。这篇接着唠我们在这套机制上栽过的一个真实的跟头——一次线上事故,我们内部叫它"停了个寂寞"。
事故:用户在 agent 分析到一半的时候点了"停止",界面也提示停止成功,结果 agent 理都没理,照常跑完了全程,token 照烧,结论照出,用户一脸懵。
排查之后发现,根因是"停止"这个请求必须精确落在"任务正在跑"的那一小段时间窗口里才有效,早一点晚一点都扑空。解决方案是给每一轮任务在 Redis 里立一块"墓碑":停止请求可以先于任务落地,任务真正开工前必须先看一眼墓碑。从此不管谁先谁后,晚到的一方总能看到对方留下的记录。
复盘:停止信号是怎么扑空的
要理解这个 bug,得先看清楚一轮分析从"用户点发送"到"真正开跑"要走几步:
- 接口收到消息;
- 消息被追加到这个会话的 Redis 队列里排队;
- 某台机器上的管家抢到锁,从队列里取出这条消息;
- 管家真正调用大模型,开始跑。
这四步之间隔着网络、排队和抢锁,快则几十毫秒,慢则几秒。而当时我们有两种停止信号,恰恰都覆盖不了这段路:
- 实时广播:点停止时向所有机器广播"停掉这个任务"。但它只能找到正在跑的任务——任务还在排队、还没开跑时,广播喊了一圈没人认领,就这么过去了。
- 排队的中断消息:往队列里塞一条"中断",等管家处理到它时执行停止。但管家是按顺序处理队列的——它会先把排在前面的用户消息跑完,才轮到那条中断。等于你喊了停,但你喊停的话得排在这轮分析后面才被听到。。
两条路都扑空,就出现了那个尴尬的画面:用户明明按了停止,任务却从从容容跑完全程。这类 bug 还有个讨厌的特点:几乎没法复现。它要求停止请求恰好落在那几百毫秒的窗口里,测试环境点一百次也碰不上一次;但线上量一大,它就是天天发生的事。分布式 bug 的常态,习惯了就好(并不)。
修法:先立碑,再开工
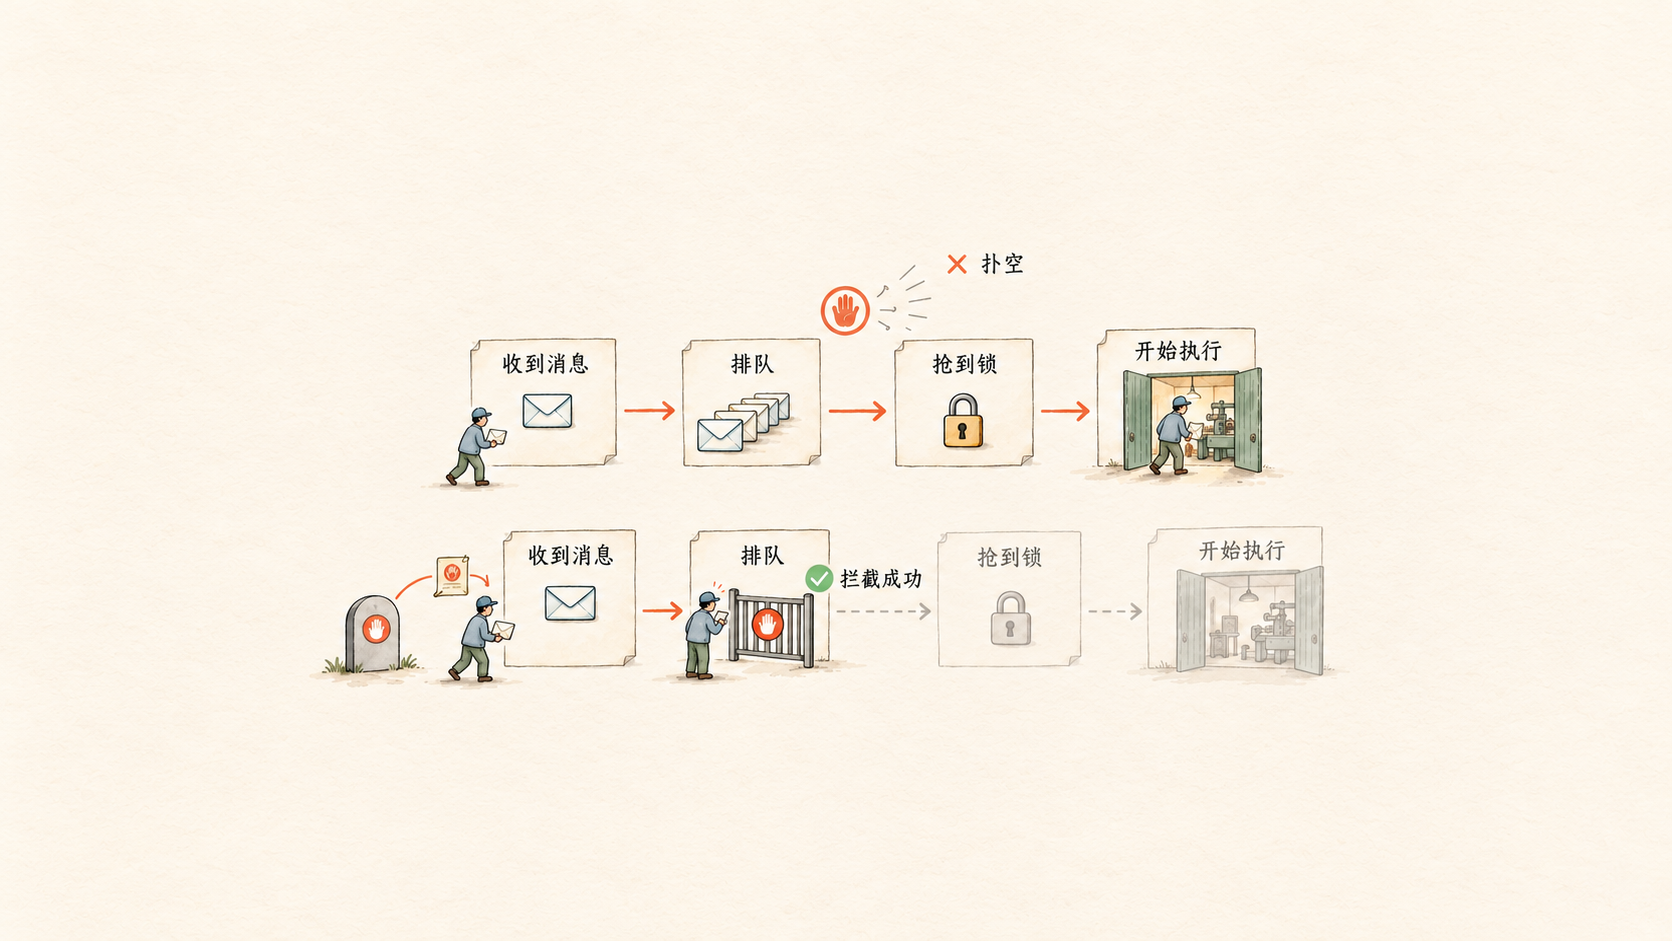
上:停止信号在两个环节之间扑空;下:墓碑立在开工之前,总能被看到。
解法思路:既然"停止"和"开始"的先后顺序不可控,那就别让正确性依赖这个顺序。
我们给每一轮任务在 Redis 里建一条生命周期记录(一个带 72 小时有效期的哈希),状态比较有限:排队中 → 运行中 → 已请求停止 → 已停止,正常走完则是 已完成 或 已失败。围绕它有三个动作,分别在三个关口各把一道:
第一关,点停止的时候——没有记录就先立一块。 停止接口收到请求后,如果这轮任务的记录还不存在(说明消息还没来得及入队),就直接创建一条状态为"已请求停止"的记录——任务还没出生,“死亡证明"先开好了,这就是我们说的"墓碑”。如果记录已存在,就原子地把它推进到"已请求停止"。
第二关,消息入队之前——先看墓碑再排队。 消息真正被追加进 Redis 队列之前,先查一次记录:如果撞见墓碑(已请求停止或已是终态),直接拒绝入队,给用户返回一个明确的错误,而不是照常排进去、指望后面有人再拦一次。
第三关,管家动手之前——再验一次。 消息可能在队列里已经躺了一阵,停止请求也许就是在这段等待期里进来的。所以管家真正开始执行前会最后确认一次:看到"已请求停止",就把它翻成"已停止",跳过执行,不调用模型,直接走中断收尾。
三道关卡总结:不管停止和开始谁先谁后,晚到的那一方开门时,总能看到先到的留下的记录。竞态没有被消除,但它的结果从"看运气"变成了"必然有人看见"。
几个容易翻车的细节
方案一句话能讲完,但要做到不翻车,有几个细节值得单独唠唠。
验明正身,三重核对。 墓碑是按"账号 + 任务 ID"寻址的,操作时会同时核对发起人、会话 ID 和任务代数(generation,每次重试会递增),任何一个对不上都直接拒绝。这是防"诈尸"的:一轮已经终态的任务,绝不能被一条迟到的旧消息复活重跑——想象一下用户上个月点过停止的某轮分析,因为某个重试逻辑又跑了一遍,token 又烧一遍,那才是真正的灵异事件。
终态只进不退。 收尾动作全部幂等:同一代任务重复上报"完成"或"停止",只会得到"已处理过"的回执,不报错也不改状态。分布式系统里消息至少送达一次是常态,状态机必须对重复免疫。
停父及子。 主 agent 派出去的子 agent(第一篇提过,子任务跑在独立的子会话里),开工时挂在父任务的那块墓碑下面。因为在用户眼里"一轮"就是父任务那一轮,子 agent 只是这一轮里的活儿——所以停掉父任务,就应该连还没开工的子任务一起停掉。墓碑机制天然可以应付这个场景,不用额外发明东西。
入口只留一个。 处理过程中我们顺手做了一次清理:停止的 HTTP 入口只保留一个,旧的取消路由整条删除,不留别名。停止这种性命攸关的路径,多一个入口就多一种漏接墓碑的可能,别给自己挖坑。
这个模式不止 agent 能用
跳出我们这个项目,“墓碑"其实是分布式任务取消的通用解法。只要你的系统满足"任务先排队、后执行,取消指令随时可能到达”,就会遇到同样的窗口问题——定时任务调度、异步工单、批量作业,全都一样。答案也一样:别试图让取消信号追上任务,给任务一个随时可以查询的"死亡登记处",让执行路径上的每一道关口自己去看。
当然,墓碑只解决了"还没开始怎么停"。另一半问题是:已经跑到一半的任务,停在哪一行代码才安全?模型正在等十个工具调用的结果,你总不能停在第九个半——那会留下一个上下文里的"悬空调用",下一轮直接报错。下一篇就讲我们的"工具调用余额"算法:agent 跑到一半被用户插话,该在哪一行代码停下来。
这是 “Flashduty AI SRE( https://www.flashduty.com )技术揭秘” 系列的第二篇。我们在做一个专注 SRE 领域、帮你做故障根因分析的 AI Agent 产品,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。