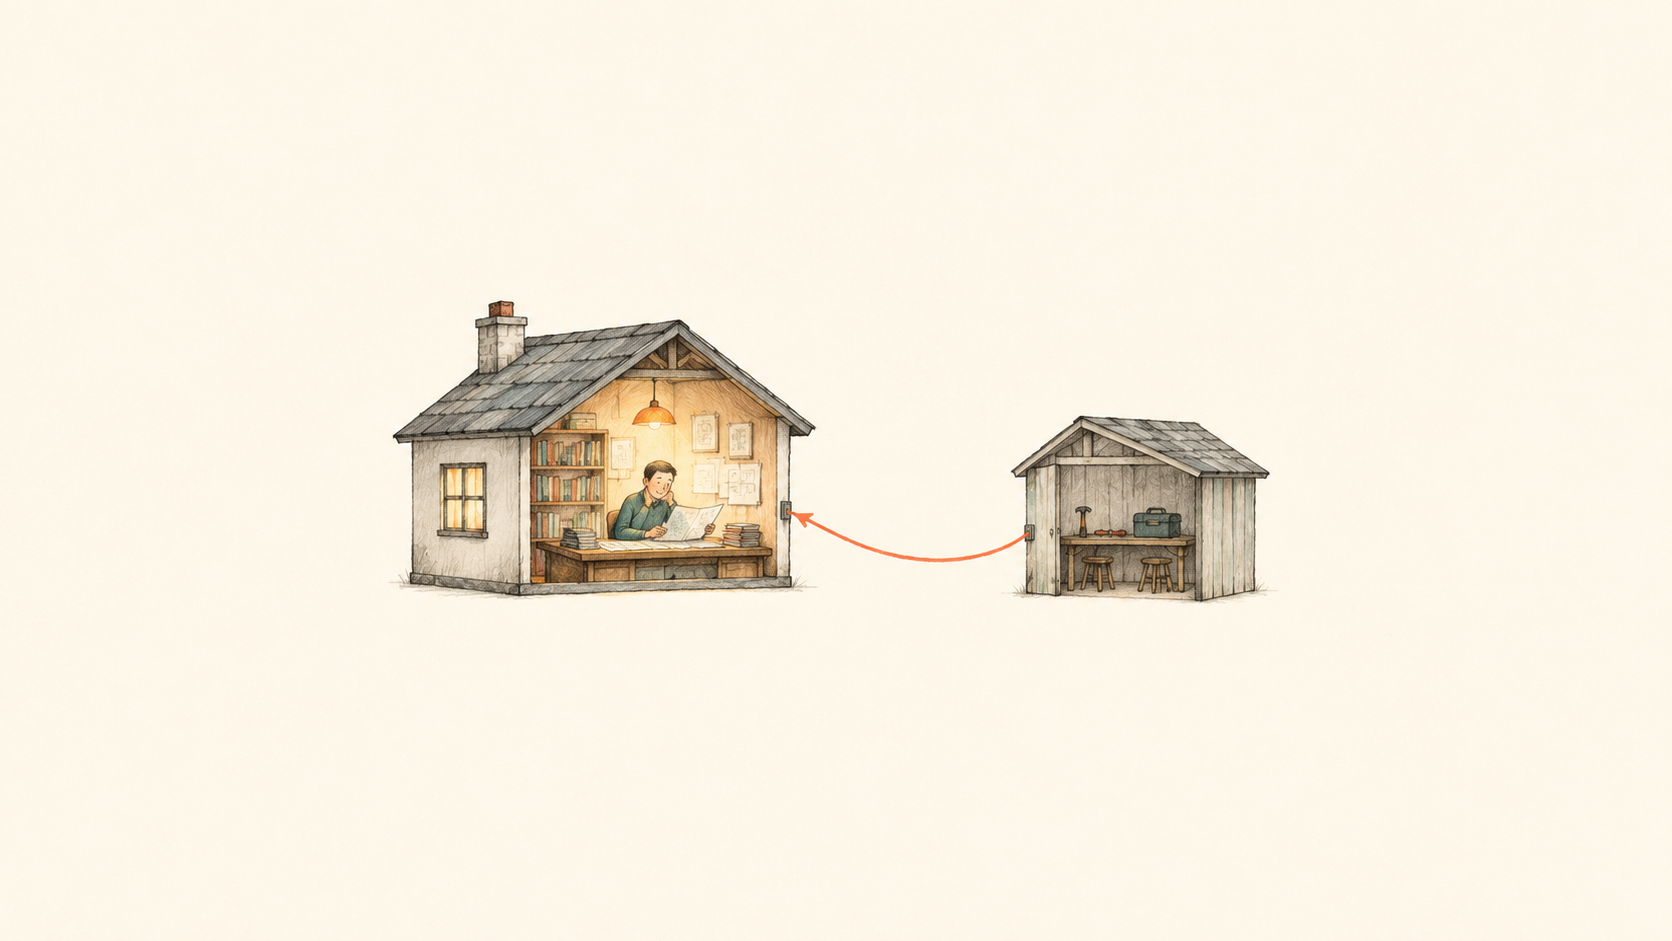
脑子留在小楼里,小屋里只有一双手和一根主动拉出来的线。
Flashduty AI SRE 是一个专注 SRE 领域、帮你做故障根因分析、日常运维工作的 AI Agent 产品,注册即可免费试用。这是系列文章《Flashduty AI SRE 技术揭秘》第 9 篇,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。
一个绕不开的问题
我们做的是帮运维团队排查故障的 AI agent。排查故障,就得能碰到客户的系统:查日志、看监控、在服务器上跑命令。而这些系统大多藏在客户的内网里,外面的人是进不去的。
那么问题来了:这个 agent 应该部署在哪儿?
最直觉的答案是"离数据越近越好":把整个 agent 打包,装进客户自己的环境里。数据不出门,安全合规也好解释。
我们的选择恰恰相反:agent 真正"思考"的部分永远留在我们的云端,客户那边只跑一个负责"动手"的小程序。 这个小程序由客户自己部署在自己的内网里,我们叫它 BYOC Runner(BYOC 是 Bring Your Own Cloud 的缩写,意思是"用你自己的环境")。
这篇就讲讲这个决定背后的思路,以及它帮我们省掉了哪些长期的麻烦。
先把"大脑"和"双手"分开
一个 agent 其实可以拆成两部分。
大脑负责思考:记住这次对话聊到哪儿了、整理要发给模型的内容、写好给模型的指令(prompt)、调用模型、决定下一步该用哪个工具。这个系列前八篇讲的所有东西——压缩、缓存、紧急裁剪、知识包、输出截断——都是大脑里的事。
双手负责干活:按照大脑的指令跑一条命令、读一个文件、调用一个外部服务,再把结果带回来。
打个比方:大脑是坐在总部、经验丰富的老师傅,双手是派驻在客户机房里的一位操作员。老师傅通过电话告诉操作员"去看看这台机器的日志"“把这条命令跑一下”,操作员照做,再把看到的念给他听。
判断标准只有一条:大脑跟着用户入口走
大脑放在用户和它对话的那一侧。
我们的用户是在哪里和 agent 对话的?在浏览器里打开我们的网页,或者在即时通讯工具(IM)里和它聊。这些入口都在云端,所以大脑就放在云端。
为什么这么看重"大脑和入口在一起"?因为一旦两者分家,它们之间的每一次通信都要跨过一道边界,而每跨一次都要交一笔"过桥费"。更麻烦的是,这笔钱不是建好桥就完事的一次性投入,而是永远都要持续缴纳的运营成本。
具体有三笔。
第一笔:消息和状态的同步
大脑在客户那边,用户却在云端。模型一个字一个字吐出来的回答、对话状态的每一次变化,都得从客户那边实时传回云端。第 1 篇讲过的那一整套对话运行机制(排队、加锁、把每个事件存进数据库),就要再造一套能跨两个网络工作的版本。
第二笔:升级和版本混乱
大脑是我们改得最快的部分:指令在调、工具在加、各种机制在改。如果大脑分散在每一个客户的环境里,每次改动就变成了一次"给成百上千个客户统一升级"的大工程。
这笔账有多重,我们自己深有体会。光是客户那边那个小小的"双手"程序,为了管好它的版本,就已经有一整套机制:
- 它每隔一段时间会给云端发一次"心跳",顺便报告自己的版本号;
- 云端根据配置告诉它"建议升级到哪个版本、去哪里下载";
- 版本低于某个下限的,云端直接不给它派活。
这个"版本下限"来自一次真实的事故:旧版本的程序会让多个对话共用同一个目录,结果把知识文件放错了地方。
这套机制本身很简单,云端不记录任何升级进度:它只负责告诉对方目标版本和下载地址,什么时候升级由客户那边的程序自己决定;下一次心跳报上来的版本号,就是升级的结果。
一个薄薄的"双手"程序已经需要这样一套机制,如果把整个大脑的复杂度都乘上去,每次发版都会变成一场噩梦。
第三笔:调用模型要绕路
大脑在客户那边,每一次调用模型都得从客户的网络往外发请求。而每家客户的网络都有自己的代理、审计规则和访问白名单,各不相同。任何一次调用都可能卡在某个我们远程根本够不着、也看不见的环节上。
大脑在云端,还多了一种可能:跨环境协同
大脑和入口放在一起,省掉的是过桥费。而大脑放在云端,还带来一个额外的好处:它站在所有环境的"上方"。
现实中,客户的系统往往分散在好几个地方:代码仓库在办公网,监控指标在生产机房,某些日志又在另一个云的另一个区域。一次故障排查,很可能既要看最近的代码改了什么,又要看出事那段时间的指标曲线。
如果大脑装进了某一个环境,它就只看得到这个环境里的东西。想跨环境,就得让多个环境里的大脑互相通信、同步状态——又回到了过桥费的老问题。
大脑在云端就不一样了。每个环境里的"双手"都主动连到同一个云端,大脑天然能同时看到所有的"双手"。将来在一次排查里,它就可以让 runner1 在办公网里读代码,让 runner2 在生产机房里查指标,再把两边的结果放在一起推理——就像总部的老师傅同时给两个机房的操作员打电话,一边问代码,一边问指标。
需要说明的是,这还是我们规划中的方向:目前一个对话选定执行环境后就固定在那里(下面会讲具体规则)。但正因为大脑在云端,要做到这一点,改的是大脑里的调度逻辑,不需要在客户的各个环境之间互相打通网络,也不需要让多个大脑彼此同步。
客户那边的"双手"长什么样
“大脑在云端"要成立,客户那边的程序就必须足够轻、足够守规矩。我们的设计有这么几条。
只往外打电话,不接电话
客户那边的程序会主动向我们的云端拨出一条长期保持的连接(技术上是 WebSocket 长连接)。之后,云端就借着这条线把任务派下去,再把结果收回来。
这意味着客户的防火墙不需要开放任何允许外部访问内网的端口。在企业客户的安全评审里,这是一条可以直接写进答案的事实。
电话线上只传"干活指令”
在这条连接上传输的内容只有一种格式:任务编号 + 要做什么 + 参数。比如要跑的命令、要读的文件路径、要访问的网址。
这条线上没有给模型的指令,没有对话记录,没有工具的定义说明——这些东西从来不会离开云端。客户那边的程序也从来不调用模型。它就是一双手,只管照做。
派给谁,规则简单到可以背下来
一个账号可以在不同地方部署多个这样的程序,有的是整个账号共用的,有的是某个团队专属的。对话第一次开始干活时,系统按固定的顺序选择在哪里执行:
- 对话属于某个团队,就优先用这个团队专属的;
- 没有的话,用整个账号共用的;
- 再没有,就用我们云端的沙箱。
有几条铁律:
- 永远不会派到别的团队的程序上;
- 一旦选定,这个对话就一直在那里执行,不会中途换地方;
- 用户明确指定的环境如果离线了,就直接告诉用户出错了,绝不悄悄换一个地方执行。偷偷改变命令的执行位置,比报错要糟糕得多。
电话断了,平台替 agent 等一会儿
客户那边的程序重启,或者网络抖了一下,连接会短暂中断。这时如果有任务要派,系统不会马上报错,而是最多等 30 秒,看它能不能重新连上。
为什么由平台来等,而不是让 agent 自己等?因为 agent 手里没有合适的"等待"手段:直接执行 sleep(让程序暂停几秒的命令)会被我们的命令安全检查拦下来;而在连接断开时,派发命令这个动作本身也会失败。
等待期间:
- 一个包都不会发出去;
- 已经发出去的任务绝不重发,所以不会出现同一条命令被执行两次的情况。
如果 30 秒还没连上,返回给模型的错误信息是一段专门写给模型看的操作指引:任务没有送达、什么都没有执行过、重试不会造成重复执行;如果重试一两次还不行,就不要再尝试调用环境了,把已经得出的结论交给用户,并如实说明"执行环境出了问题",作为一个阻塞性故障上报。
云端升级时,连接平稳交接
我们自己的云端服务也会滚动升级。升级时,即将下线的服务器节点不再接受新的连接;如果心跳发现这条连接应该归另一个节点管了,就主动断开,让客户那边的程序重新拨号,连到新节点上。
还有一个反方向的克制:心跳依赖的缓存服务(Redis)如果抖了一下,我们故意不断开连接。一次短暂的缓存抖动,不应该被放大成所有客户的程序同时掉线。
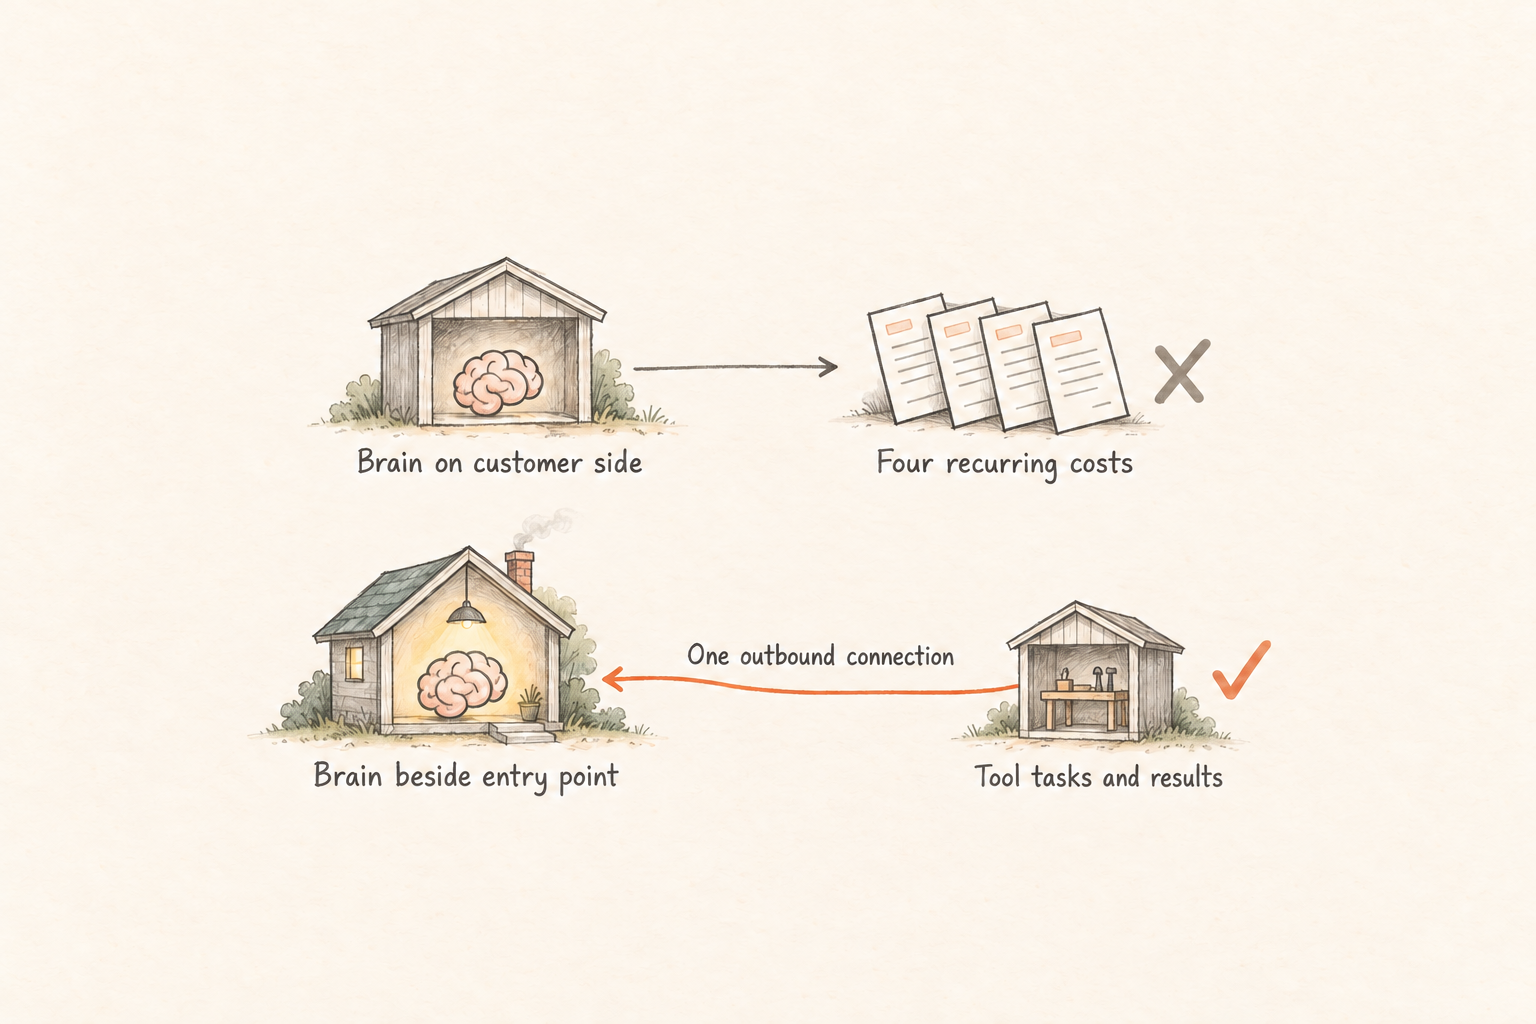
上:大脑搬到客户那边,过桥费永远都要交;下:大脑留在云端,一条主动拨出的线只传干活指令。
什么时候这个结论会反过来
我们的判断标准是"大脑跟着入口走",而不是"大脑永远在云端"。当入口搬家时,结论就会翻转:
- 如果客户要求完全部署在自己的机房里,连用户使用的网页都装在客户内网——那大脑就应该整个搬过去,而不是只搬一半;
- 如果数据主权的要求极端严格,连模型都必须部署在客户那边——那么入口、大脑、模型都在客户一侧,反而是云端的那部分需要重新考虑。
过桥费的根源从来不是"大脑在云端",而是大脑和入口分了家。设计自己的架构时,可以先找到用户从哪里进来,把大脑放在它旁边,然后数一数每一次跨边界的通信要交什么费用。
我们明确不做的三件事
把边界说清楚,免得大家以为这套架构无所不能:
- 不替客户托管。 客户那边的程序永远由客户自己部署、自己掌控,我们不代管客户内网里的任何东西;
- 不从云端反向打通客户内网。 唯一的通道,就是客户程序主动拨出的那条连接;
- 不在多个程序之间做智能调度。 选哪个程序执行,靠的是固定的规则(本地优先、按编号排序),不会根据负载来分配。这些程序不是一个可以随意调配的资源池,而是对话的"归属地"。这和前面说的跨环境协同并不矛盾:那是大脑根据"数据在哪儿",把不同的任务明确交给不同环境的程序,而不是根据负载把同样的活随意分来分去。
小结
- agent 可以拆成"大脑"(思考、调度、调用模型)和"双手"(执行命令、读文件);
- 判断标准只有一条:大脑放在用户入口的同一侧。我们的入口在云端,大脑就在云端;
- 大脑和入口分家,要永远交三笔过桥费:同步、升级、调用模型绕路;
- 大脑在云端,还能同时看到所有环境里的"双手",为将来跨环境协同排查(比如一边读代码、一边查指标)打下基础;
- 客户那边只跑一个很轻的"双手"程序:只主动往外连、线上只传干活指令、派活规则固定、断线时由平台等 30 秒、升级时平稳交接;
- 如果用户入口搬进了客户机房,结论就该跟着反过来。
下一篇讲客户那边的"双手"手里的凭据该怎么管:我们接入 GitHub 时没有用 MCP(一种给 AI 接入外部工具的标准协议),一个新工具都没加——而是把访问令牌直接放进命令行环境里,让 agent 用它本来就会用的 gh 命令。
这是 “Flashduty AI SRE技术揭秘” 系列的第九篇。我们在做一个专注 SRE 领域、帮你做故障根因分析的 AI Agent 产品,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。