不在模拟台上考,就在日常的工作台上考。
这是《Flashduty AI SRE 技术揭秘》第 21 篇。查看 SRE Agent 架构与工程实践系列,或先读 BYOC Runner 的部署边界和失败模式分类。
测 agent 的基准分,常规做法是搭一套评测环境:mock 掉工具、简化掉运行时,让 agent 在一个受控的"考场"里跑题。这套做法的分数有个语义问题——它测的是"我们的 mock 之下的 agent"。mock 和生产的每一处差异,都是分数可信度的一个洞。
我们的做法是反的:不给 benchmark 造考场,把 benchmark 的容器直接注册成生产平台的执行环境(就是第 9 篇讲的 BYOC runner 机制),让基准测试走生产全链路。这篇讲 SWE-Bench Pro 和 Terminal-Bench 两个 harness 怎么接,以及这条路照出来的几个坑。
核心要点
- 评测方式: 将基准测试容器接入生产 Agent 的会话与执行链路,adapter 负责桥接容器和生命周期,不另写一套 Agent loop。
- 两种接法: SWE-Bench Pro 为实例创建执行环境并收集代码 patch;Terminal-Bench 通过宿主机 Runner 操作任务容器。
- 结果怎么解释: 评测有助于发现生产链路问题,但基准分数只反映所选任务上的表现,不能代表所有客户故障场景。
全链路的意思是全链路
“走生产链路"在我们这里不是修辞,agent 在评测里经过的每一步都是生产代码:创建会话的接口、环境绑定的选择路径、SSE 流式协议、工具调用的完整语义——输出截断、大结果落盘、知识铺盘,一样不少。评测的 adapter 只做一件事:桥接 benchmark 的容器和会话生命周期。adapter 里没有第二套 agent loop——这句话就是我们的论点本身,评测和生产的差异被压到了"容器编排 + 任务 prompt + 结果收集"这一层。
SWE-Bench Pro:每个实例一个环境,patch 用 git diff 收
SWE-Bench 的每个实例是一个官方镜像的容器,里面有一个真实代码仓库。接入方式:容器里跑起 runner 进程,从容器内主动拨出注册成执行环境,agent 从云端把工具调用派进容器。
几个实现细节,每个都有来历。
每个实例建一个独立环境。 环境的连接 token 只在创建时返回一次,且平台强制单 token 单连接——想用一个静态 token 服务并发容器,结构上就不可能。这顺便保证了实例间的隔离是平台级的。
patch 提取使用 Git diff。 agent 跑完后,先把 harness 物化进工作区的脚手架(runner 二进制、.outputs/、知识目录等)追加进 exclude,再用 git add -A 收集变更并提取 patch。顺序很重要:exclude 只影响未跟踪文件,要在暂存之前设置;对已有跟踪源码的修改不受它影响。每条 exclude 模式还必须根锚定——不带斜杠的 sessions/ 会在任意深度匹配,曾经差点把 Django 自带的 sessions/ 包里 agent 新写的文件静默吞掉。
harness 自己不打分。 产出的是官方格式的 prediction 文件,评分交回 benchmark 官方脚本。打分逻辑是 benchmark 的定义,我们不复制——复制一份打分逻辑,等于又造了一个可能漂移的 mock。
Terminal-Bench:一个 runner,docker exec 进所有容器
Terminal-Bench 的接法更轻:宿主机上跑一个 runner 进程注册成环境,benchmark 为每个任务起各自的容器,runner 不进容器——agent 的工具调用经 runner 用 docker exec、docker cp 从宿主侧伸进任务容器执行。就像值班工程师远程登进一台机器:操作在容器里发生,操作席在容器外。
任务隔离就是容器隔离,而容器匹配是严格的:按规范化后的项目名匹配任务容器,匹配不到、或者候选不止一个,直接报错——绝不静默绑到 docker ps 列表的第一个(陈旧容器造成的歧义,绑错就是给错任务打分)。单个 runner 服务 10-20 个并发任务没有平台侧瓶颈,真实边界在宿主机的 Docker 资源和模型 API 限流。
评测照出来的,都是生产的坑
“评测即生产"最值钱的产出不是分数,是评测把生产的坑提前踩出来。两个例子:
[DONE] 不等于完成。 生产的 SSE 协议里,服务端空闲泵五分钟没帧也会发同样的 [DONE]——流结束了,但 actor 可能还在跑。adapter 必须在流结束后轮询确认会话真的终结。还有一个更阴的:初次请求失败时,会话从未进入运行集合,轮询会立刻判定"已结束”,把一个传输失败伪装成"干净跑完但没输出”。这两种假象在 mock 环境里都不存在——mock 的流永远诚实。
工作区根目录不是仓库。 生产 runner 有一个会话暂存区机制,会把文件工具的工作区根指到空的暂存目录而不是代码仓库——这个生产行为在评测里的表现是"agent 对着一个空目录分析代码"。解法是在任务 prompt 里用字面绝对路径告诉 agent 真相。这个坑在生产里同样影响真实用户场景,评测只是让它现形得更快。
评测发现的失败有制度化出口:跑批、聚类失败、修复、重跑的循环是固定动作;压测专用的失败词汇(会话卡死、工具空转、压缩丢上下文……)写在统一失败模式分类的压测部分。它让 benchmark、线上审计和离线评测有共同定义;分类在不同流程中的实际读取方式仍有差别。
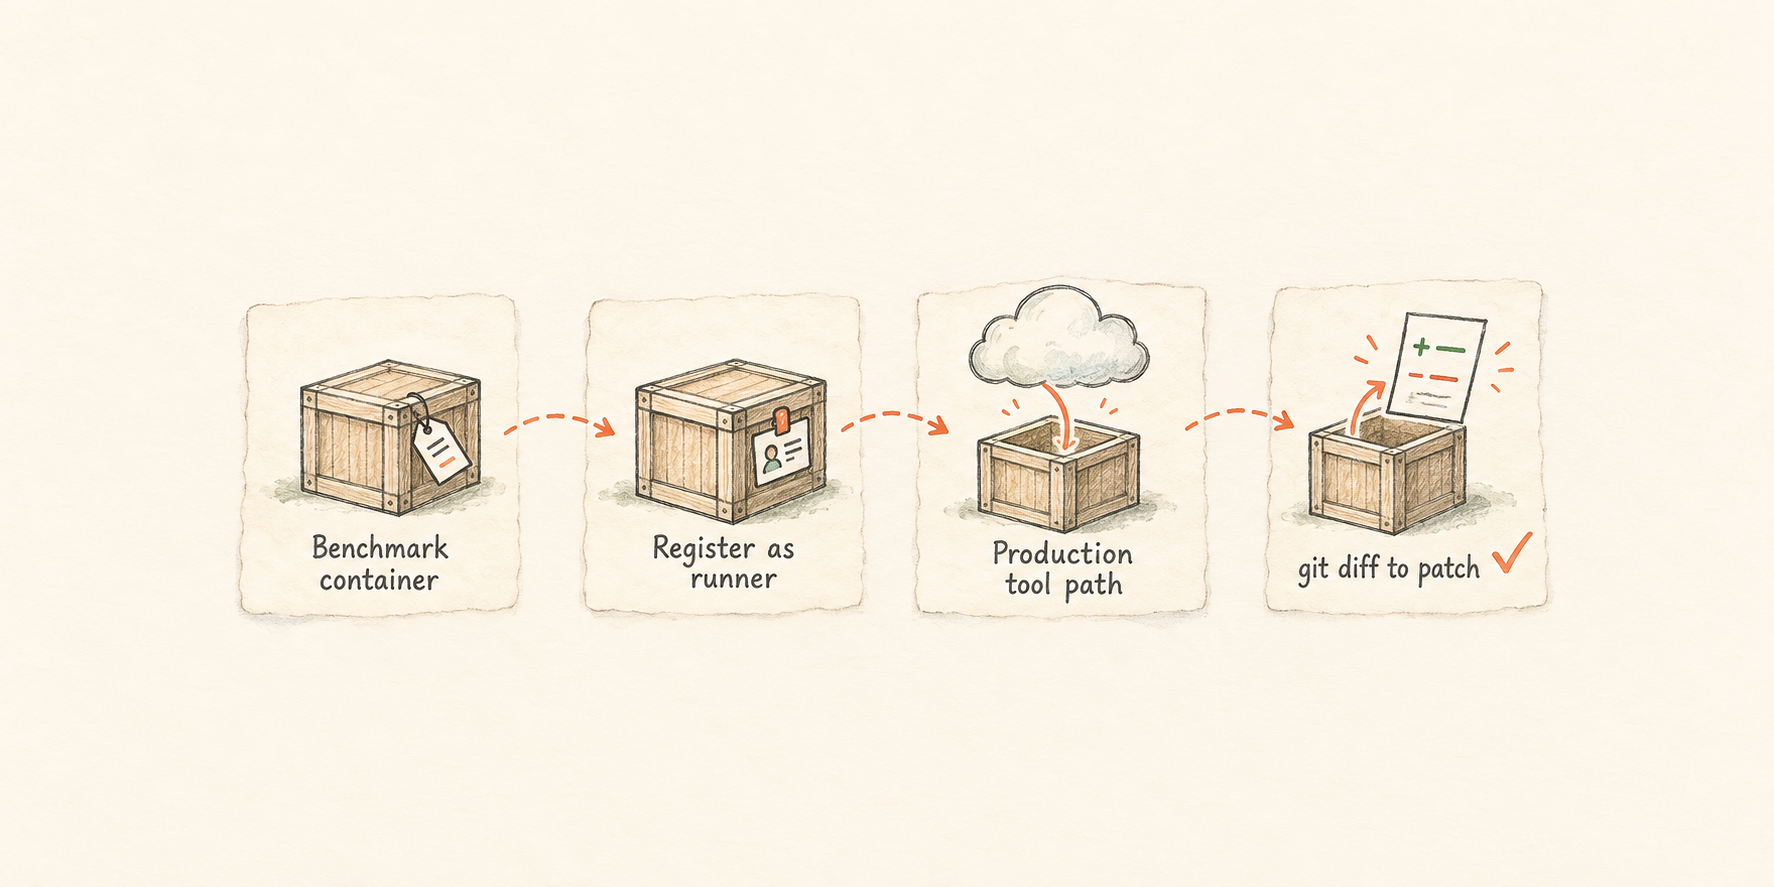
SWE-Bench 容器就是生产执行面:工具走生产链路进来,patch 用 git diff 出去。
置信度的含义
每实例建环境、容器编排和 docker exec 的间接层都有成本,换来的是评测尽量经过真实生产链路。这个分数反映的是生产形态在所选基准任务上的表现:它能暴露模拟环境容易漏掉的运行时问题,但不能直接代表所有客户环境和真实故障的表现。还需要结合生产会话审计和实际场景评测一起判断。
下一篇进入系列的最后一部分,先讲一个所有 agent 产品都会得的慢性病:prompt 膨胀,和我们的闭环疗法。