线上和离线使用同一套定义,才能讨论各自发现了什么。
Flashduty AI SRE 是一个专注 SRE 领域、帮助团队做故障根因分析和日常运维的 AI Agent 产品。这是《Flashduty AI SRE 技术揭秘》第 19 篇,分享我们在 Agent 工程中的设计、踩坑和取舍。
Agent 给出了一份故障分析报告,但结论不对。接下来要改进它,光记一笔“这次失败了”是不够的:它是根因判断错了,还是查到了证据却没有用在结论里?又或者工具反复调用,始终没有推进分析?不同原因需要不同的修复方法。
我们把这些问题整理成一套失败模式分类,同时用于两件事:离线评测拿历史故障测试 Agent,由 judge 判断表现;线上审计从生产会话中寻找失败样本。两条路径面对的数据不同,却经常需要讨论同一种失败。如果各自维护定义,时间一长,离线报告和线上审计即便用了相同名称,也可能说的不是同一件事。
一份文件,写清楚失败是什么
我们把分类集中在 failure-modes.yaml 中。原稿记录的版本共有 33 条:19 条来自离线评测,8 条来自线上审计,另外 6 条用于压测。每条模式包含 ID、类别、严重度、描述、给 judge 的判定指引和示例,还有一个 applies_to 字段,说明它适用于哪条流水线。
举个例子,“查过证据但结论没有使用”可以同时用于离线评测和线上审计,但两边的判断范围并不完全一样。审计侧口径更宽:查到的数据没有被用于结论,就可能命中,而不只关注漏掉报警级信号。我们把两个场景的边界写在同一条模式的指引中,避免只共享一个名称,却各自猜测含义。
这份文件没有把所有文字强行整理成统一语言:来自 eval 的条目使用中文,以配合中文 judge 提示词;来自 audit 的条目使用英文。流水线根据 applies_to 取需要的子集,保留原有语言可以避免维护两套互不消费的翻译。
稳定的 ID 和顺序,也是数据契约
模式 ID 看起来只是字符串,但历史报告和账本会引用它。为了命名整齐而改掉 ID,可能让新旧记录无法直接对应。因此已有 ID 不随意改名,确实需要合并时,也要考虑已有数据如何解释。
连顺序都有一处实际影响:评测报告按照分类法里的顺序出表,“根因错误”需要排在第一条。这个要求没有只留在文档里,而是由测试检查。以后有人调整文件顺序,测试会提醒他这可能改变报告呈现。
这些约束不意味着分类法不能变化。它们只是提醒我们:一旦定义被程序和历史记录使用,改动就不再只是编辑一份文档。
共用定义,不代表每个消费者都能自动读取
离线评测在组装 judge 提示词时读取 YAML,按 applies_to: eval 筛选,再把相应模式放入 judge 的输入。这条路径可以直接从文件获取定义。
线上审计的 judge workflow 运行时无法访问这份文件,使用的模式 ID 枚举仍需要人工同步。代码注释明确标明了这一点。也就是说,YAML 是分类定义的集中维护位置,但审计侧还有一段手工同步环节,不能把它说成两条流水线已经自动同步。维护分类时,这段枚举仍然需要检查。
文件自身的注释也可能过时:原稿记录文件头写着 7 条 audit 来源条目,实际已有 8 条。单一维护位置能减少多份定义之间的分歧,却不能自动保证周边注释永远准确。
合并重复模式,为什么要看历史账本
2026 年统一两套分类时,我们发现审计侧有三个模式与 eval 侧重复。例如,两边都描述了工具反复打转,于是将审计侧条目合并到 eval 侧的标准 ID 下。被合并的旧名称仍留在标准条目的描述里,方便后来查找历史材料。
合并的时机帮我们省下了迁移:当时机器可比较的账本刚要建立,较早的历史只有报告中的文字描述,不参与机器对比,所以没有既有账本需要改写。如果已有大量按旧 ID 聚合的数据,就需要另外处理新旧 ID 的映射,才能解释历史趋势。
这也是为什么新建分类时,值得尽早处理真正重复的定义;等它们被长期记录和消费之后,同样的调整会牵涉更多历史数据。
分类变了,分数还能直接比较吗
假设上一次评测得了 79 分,这次得了 82 分。看起来提升了 3 分,但如果两次之间新增了失败模式、改变了判定标准或权重,这两个数字的含义就不同。直接算差值,可能把评测规则变化误当成 Agent 能力变化。
我们的 testbank 版本由测试集文件和分类法文件共同计算哈希。分类法文件发生变化,版本也随之变化。对比报告发现两侧版本不一致时,不生成 delta,让读者看不到一个未经限定、看似可以直接比较的差值。
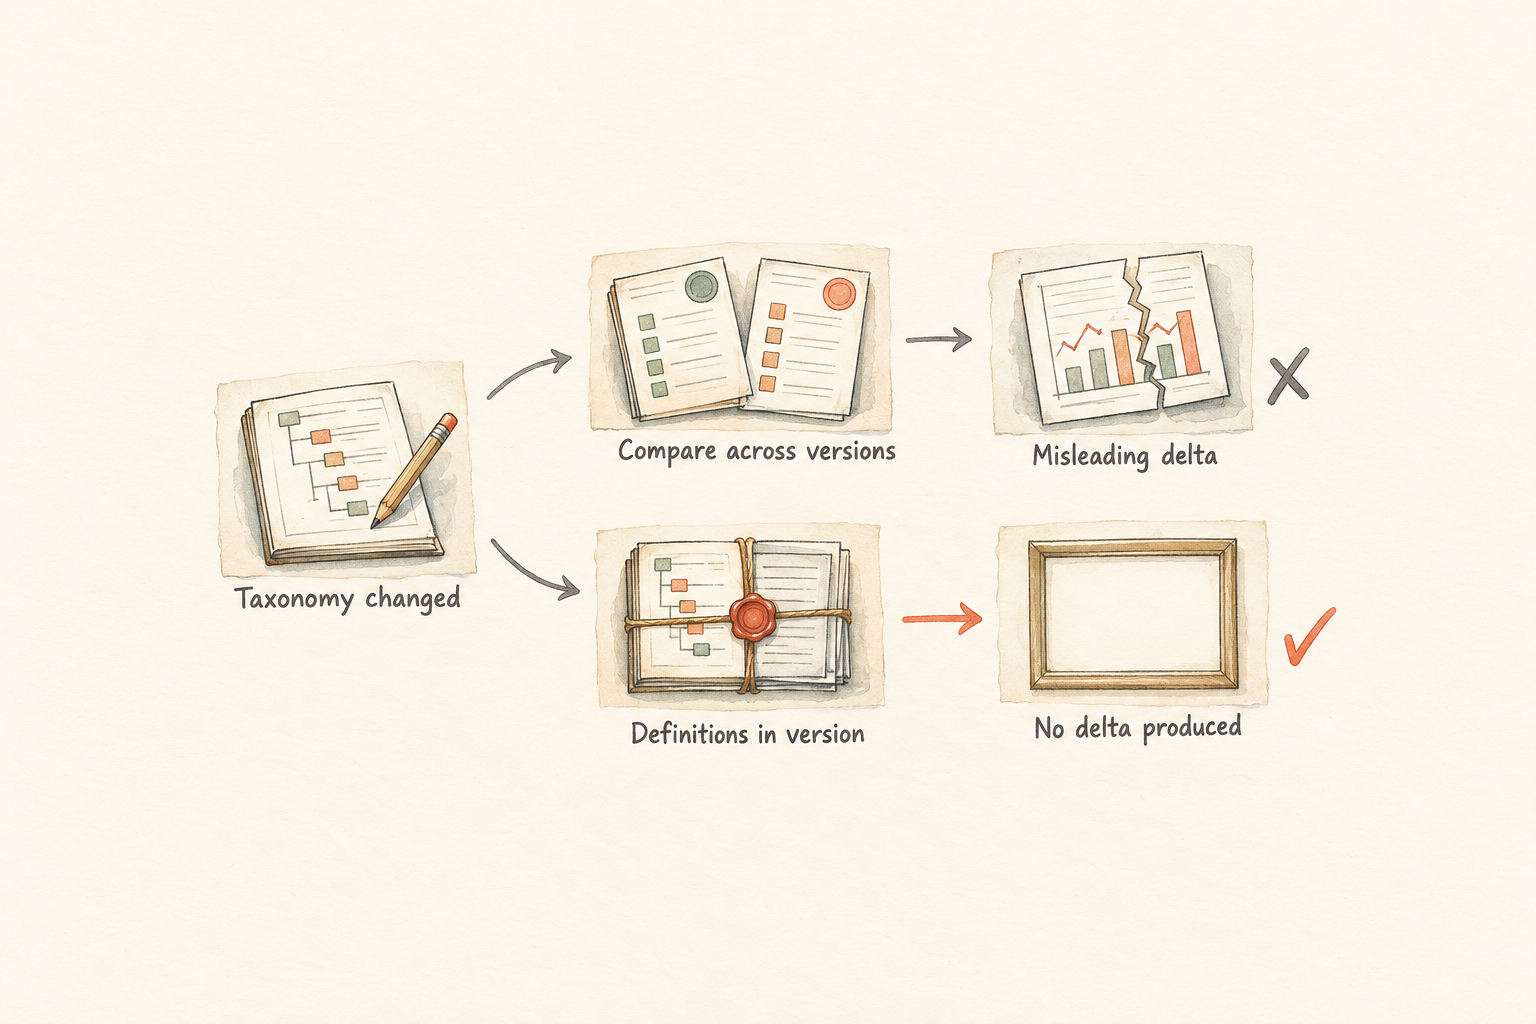
测试集和分类定义共同决定版本;版本不同时,不自动输出差值。
这并不妨碍人去研究两次结果:可以查看具体规则改了什么、各项表现有什么变化,再解释两组数字的关系。但工具不会默认把不同定义下的分数当成连续序列。若要得到同一口径下的变化,还需要使用一致的测试集和分类定义重新评测。
分类法解决的是“发现问题后,怎样描述和判断”。下一篇会往前走一步:每天有大量生产会话,怎样先找到值得送去审计的候选样本。