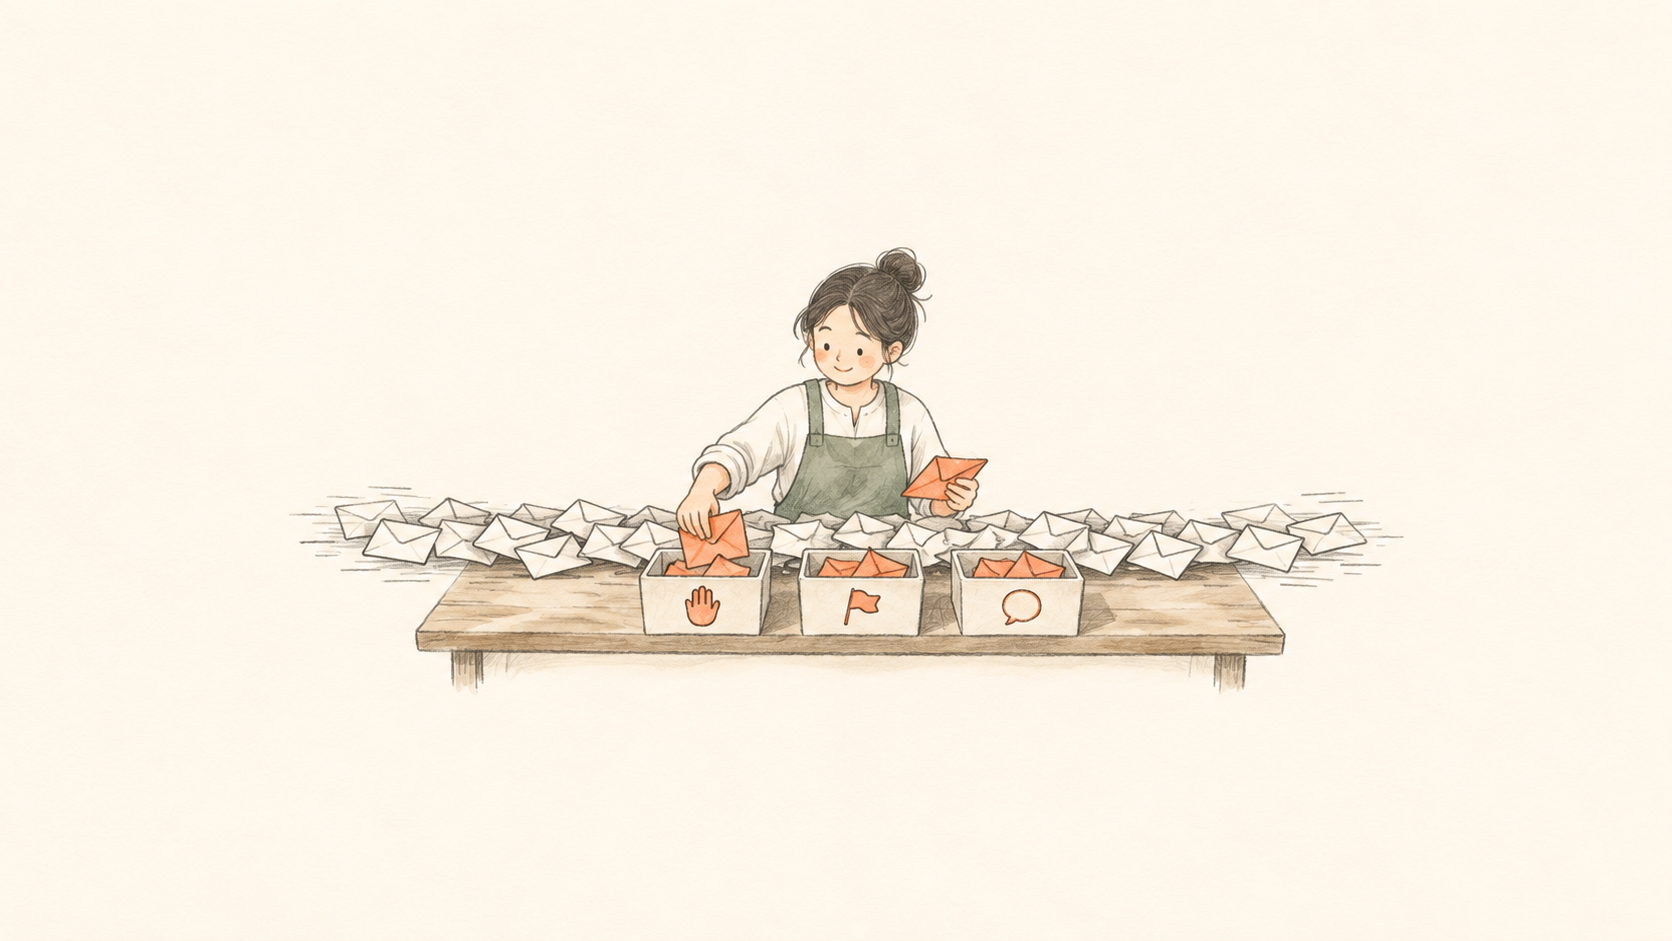
不同失败会留下不同痕迹,需要从多个入口寻找。
Flashduty AI SRE 是一个专注 SRE 领域、帮助团队做故障根因分析和日常运维的 AI Agent 产品。这是《Flashduty AI SRE 技术揭秘》第 20 篇,分享我们在 Agent 工程中的设计、踩坑和取舍。
上一篇介绍了如何给 Agent 的失败分类。但在线上审计中,分类之前还有一道筛选:每天几千个生产会话,不可能都交给人逐一阅读。应该先把哪些会话送给 judge 判断?
我们要找的是值得审计的候选样本,而不是仅凭一条信号就宣布 Agent 失败。用户打断、工具错误或点踩都可能提供线索,后续仍需结合会话内容判断发生了什么。最初我们试过用关键词筛选,后来发现这条路既会捞进大量噪音,也会漏掉明显有问题的会话。
为什么搜“不对”找不到所有问题
关键词会误报。例如搜索“不对”,也可能匹配到正常提问里的“对不对”。消息表中标记为用户发言的内容,也不一定都是人手打的:定时任务提示、后台通知、斜杠命令展开的内容都可能出现在其中。用户粘贴的报错栈里有粗话,也不等于用户在对 Agent 表达不满。
反过来,真正的异常未必包含负面词汇。校准集中有一个会话,用户连续发了六次“继续”。单看每一句,语气都很中性;放在一起,就值得检查 Agent 是否卡住、反复没有完成工作。依赖词表无法发现这种重复模式。
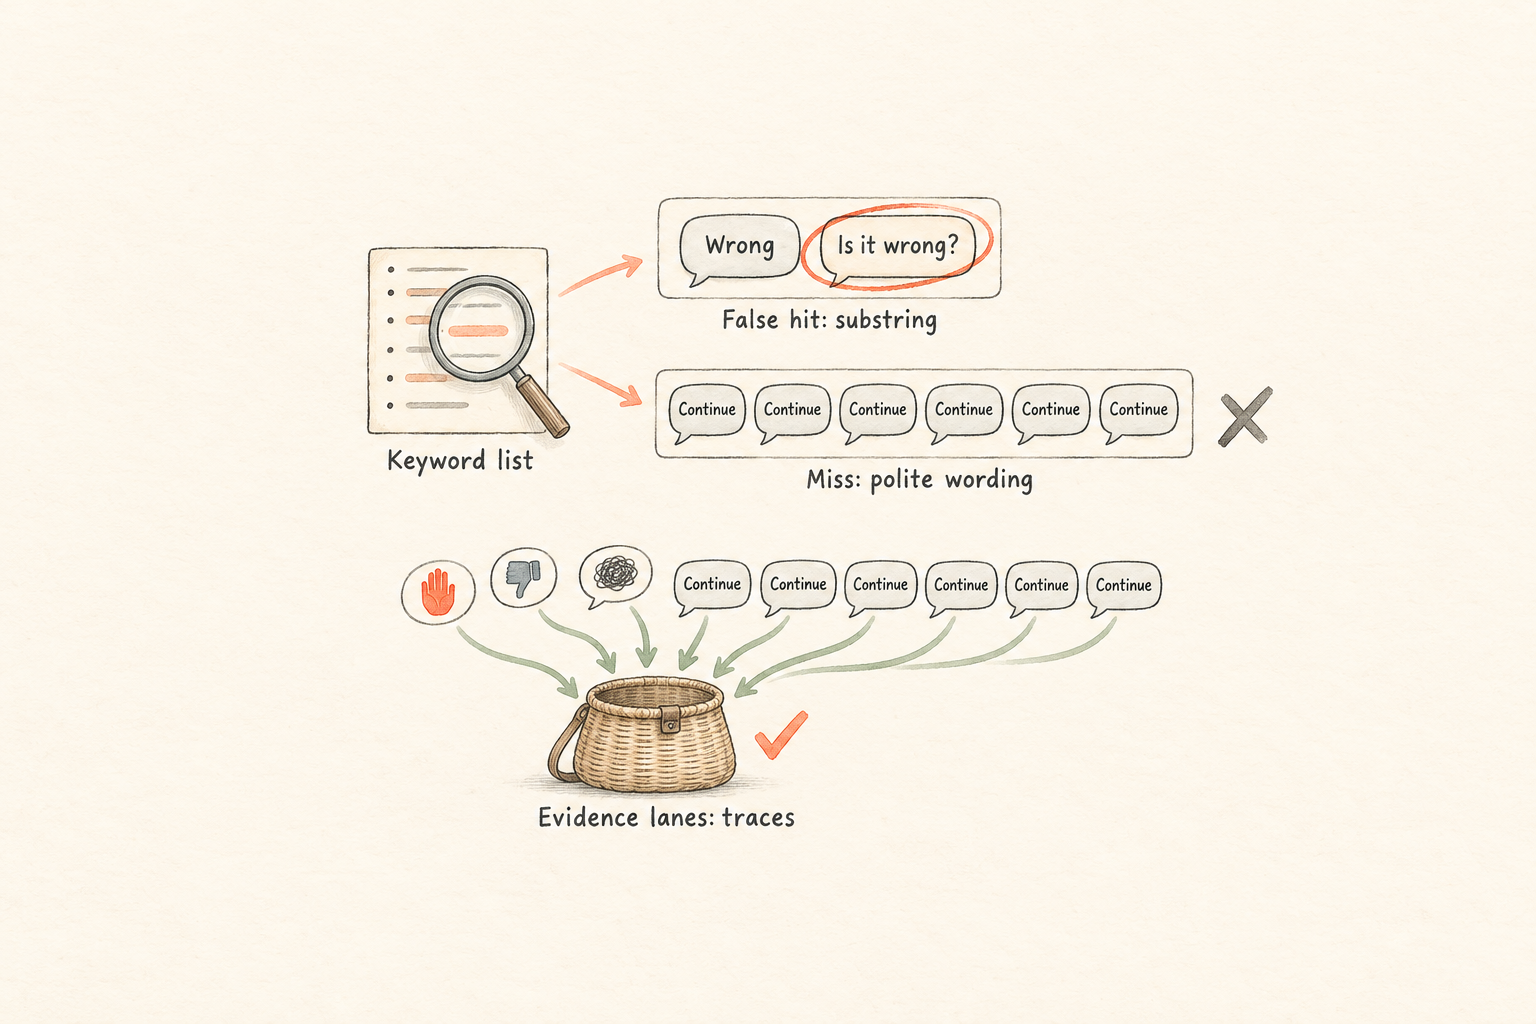
关键词容易误匹配措辞,也可能漏掉重复行为。图中的英文短句是中文案例的语义示意。
我们后来把候选选择拆成六条信号,分为三组:三条查系统记录,一条查点踩反馈,两条分析用户发言。各组分别找候选,最后合并去重。
第一组:从系统记录中找三种信号
第一组可以直接通过 SQL 查询:
- 用户打断过某一轮。 打断操作留下明确记录,值得看看用户为什么中止。
- 轮次在执行框架中失败。 例如调用方错误或 panic。
- 事件带有错误码。 这提示执行过程中出现了需要进一步查看的错误。
这些信号不依赖用户怎么措辞,但查询也要了解数据写入方式。我们曾发现,打断记录的应用名字段在写入时刻意留空:14 天窗口中的 83 条打断记录,有 82 条应用名为空。如果给事件查询加上应用名过滤,就会漏掉几乎全部这类记录。一个看似常规的过滤条件,足以让重要线索从结果中消失。
第二组:点踩需要自己的时间游标
点踩和前面的事件有一个时间上的区别。用户要先看到答案,可能过一会儿才点击“踩”。如果扫描程序只按会话创建时间往前推进,扫过这个会话之后才出现的反馈,就可能再也不会被看到。
因此点踩有单独的查询和游标,按反馈记录的更新时间推进,而不是跟着主扫描的会话时间走。这样晚到的反馈也能进入候选集合。
这条路径确实找到了其他信号没有覆盖的案例:有一次用户点踩并留言“没定位到问题”,但会话中没有打断、执行失败或错误码。如果没有单独扫描反馈,这条线索就会漏掉。
第三组:模型看语义,代码看重复
用户发言也能提供线索,但不能只凭词表。我们把其中两种任务分开处理。
第一种是判断语义:用户表达的是满意、中性、不满还是放弃?不满指向 Agent、故障本身,还是别的事情?用户对正在发生的故障生气,并不自动意味着 Agent 做错了;只有判断为不满且指向 Agent,才作为这条路径的负样本候选。
这项判断由小模型执行。原稿记录,在 99 个人工标注会话的校准集上,最小模型和中等模型的 precision 都是 100%,recall 都是 82%,但两者错在不同会话上。基于这组结果,我们选择成本更低的模型,也没有增加二次审核:在该校准集中没有观察到误报,而误报的直接代价是让下游 judge 多读一个会话。这些数字只描述这次有限的校准结果,不能保证生产中永远没有误报。
第二种是识别重复短句,不需要模型推测语气。代码检查同一会话中是否有相同短句出现三次以上;短句去掉空白后不超过 12 个字符。“继续”连发六次就会命中。这条规则在校准集中没有误报,但它找到的仍是候选,不能仅凭重复就断定失败。
两种方法各取所长:语义判断处理“这句话在表达什么”,规则处理“同一句话出现了多少次”。模型可能把每次“继续”分别理解为中性发言,计数规则则直接保留了重复这个事实。
为什么不能只挑工具调用多的会话
也可以用工具调用次数挑选“大会话”,希望复杂会话里更容易包含问题。它确实是一种筛选办法,但调用次数本身只说明工作量,不能说明用户是否遭遇了失败。
原稿给出一组 14 天窗口的对照:负样本信号共选出 85 个候选,其中 53 个带打断记录;按工具调用次数选取的量车道用满了 500 个名额,却只覆盖同一窗口内 53 个被打断会话中的 9 个。这个比较说明,在该窗口和选取条件下,按调用量排序会漏掉大量打断案例。它不表示所有打断都是失败,也不说明其他类型失败的覆盖率。
系统记录和用户反馈提供的是与问题有关的直接线索;工具调用次数则是可能与问题相关的间接指标。需要寻找负样本时,我们优先使用前者,再让后续审计判断上下文。
没有留下信号,不代表回答正确
多条路径仍然有盲区。如果 Agent 自信地给出了错误答案,用户没有点踩、没有反驳,系统也没有报错,这个会话就可能不会被上述信号选中。线上候选集不能代表所有失败,更不能用“没有选中”证明回答正确。
除了筛选候选,我们还对整个扫描窗口中的真人发言做 stance 分析,观察满意、中性、不满和放弃的分布;趋势恶化超过阈值时触发门禁。计算分布时,分母使用有真人发言的会话,而非所有会话:如果把大量自动化会话也放进分母,自动化流量增长就可能让不满比例看起来下降,掩盖真人体验的变化。
寻找失败需要多种证据,也需要承认证据没有覆盖的部分。下一篇会介绍离线评测的执行方式:把评测容器注册成生产 runner,让 benchmark 经过生产链路。