包裹太大塞不进信箱?留一张取货单,包裹放后仓。
Flashduty AI SRE( https://www.flashduty.com ) 是一个专注 SRE 领域、帮你做故障根因分析、日常运维工作的 AI Agent 产品,注册即可免费试用。这是系列文章《Flashduty AI SRE 技术揭秘》第 8 篇,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。
一条命令,几 MB 的输出
前几篇反复提到:AI agent 和普通聊天机器人最大的不同,是它会动手——查日志、跑命令、搜代码。每次动手,工具执行完的结果都会被放回对话记录里,让模型读了再决定下一步。
问题是,有些结果大得吓人。
比如让 agent 在生产服务器的日志目录里跑一条 grep(按关键词搜索文本的命令),找出所有包含 ERROR 的行。一次就可能返回几 MB 的内容。如果原封不动塞进对话记录:
- 窗口被吃掉一大块。 模型一次能读的内容有上限,一条输出就占掉一大半;
- 账单跟着起飞。 模型按读入的内容量收费,而且之后每一轮都要把它再读一遍;
- 大部分根本用不上。 几 MB 里,模型真正需要逐字看的可能不到 1%。
这篇讲我们怎么管理工具的输出。规则本身就一句话,但它背后的分工值得慢慢说。
先排除两个直觉做法
做法一:提醒模型自己注意
在给模型的说明里写一句:“请谨慎执行可能产生大量输出的命令。”
这条路走不通,原因很简单:模型在执行命令之前,根本不知道输出会有多大。它看到的只是自己写下的那条命令,grep ERROR /var/log 看起来人畜无害,谁知道日志里有几十万行 ERROR?让一个无法预知结果的人对结果的大小负责,责任从一开始就放错了地方。
做法二:在系统层面统一砍一刀
在所有工具和模型之间加一道关卡,不管哪个工具的结果,超过一定长度就一刀切掉。
这道关卡我们确实有(后面会讲),但它不是主力。因为统一的那一刀不懂内容:搜索结果该留前面还是后面?一段 JSON 里哪个字段是重点?一份文件该从哪一行切开?这些只有工具自己知道。
所以我们的答案是:输出由工具自己负责瘦身。截断是每个工具实现的一部分,而不是交给外面兜底。
100K 约定:是约定,不是一个统一的数字
规则只有一句:每个内置工具交给模型的输出,自己控制在 100K 字节以内。
这里有两个细节。
第一,单位是字节,不是 token。 100K 字节大约相当于两万多个 token。这个量级参考了 Claude Code 读文件时的额度:够做一次像样的排查,又不会一下子吃掉太多窗口。
第二,它是约定,而不是一个全局共享的数字。 代码里没有一个"所有工具共用的上限",而是每个工具在自己的实现里写死自己的上限:读文件工具是 100K,按模式找文件的工具是 100K,抓网页的工具也是 100K。仓库的贡献规范把这一条列为新工具的红线:任何新的内置工具都必须自己限制输出;真正需要吞吐大量数据的工具,不属于这一层。
为什么不在一个地方统一裁剪?因为"怎么截"是个跟内容相关的问题,每个工具的答案都不一样:
- 读文件工具按行截,带上行号,并告诉模型"下次从第几行接着读";
- 看图工具截的是它给出的文字回答,图片本身本来就不进模型的对话记录;
- 发即时消息的工具超出上限时,不是截断,而是直接拒绝发送——一条发出去的消息,总不能只发一半。
这些判断,没办法在一个通用的函数里都做对。
截断不是扔掉,而是"挪到后仓"
截断的关键不在"砍掉",而在"挪走"。
就像邮局:包裹太大塞不进信箱,邮递员不会把它扔了,而是放进后仓,在你的信箱里留一张取货单。我们的做法一样:超出的完整内容会存成一个文件,放在工作区的 .outputs/ 目录下;模型拿到的,是前面一部分内容,加上一张"取货单"。
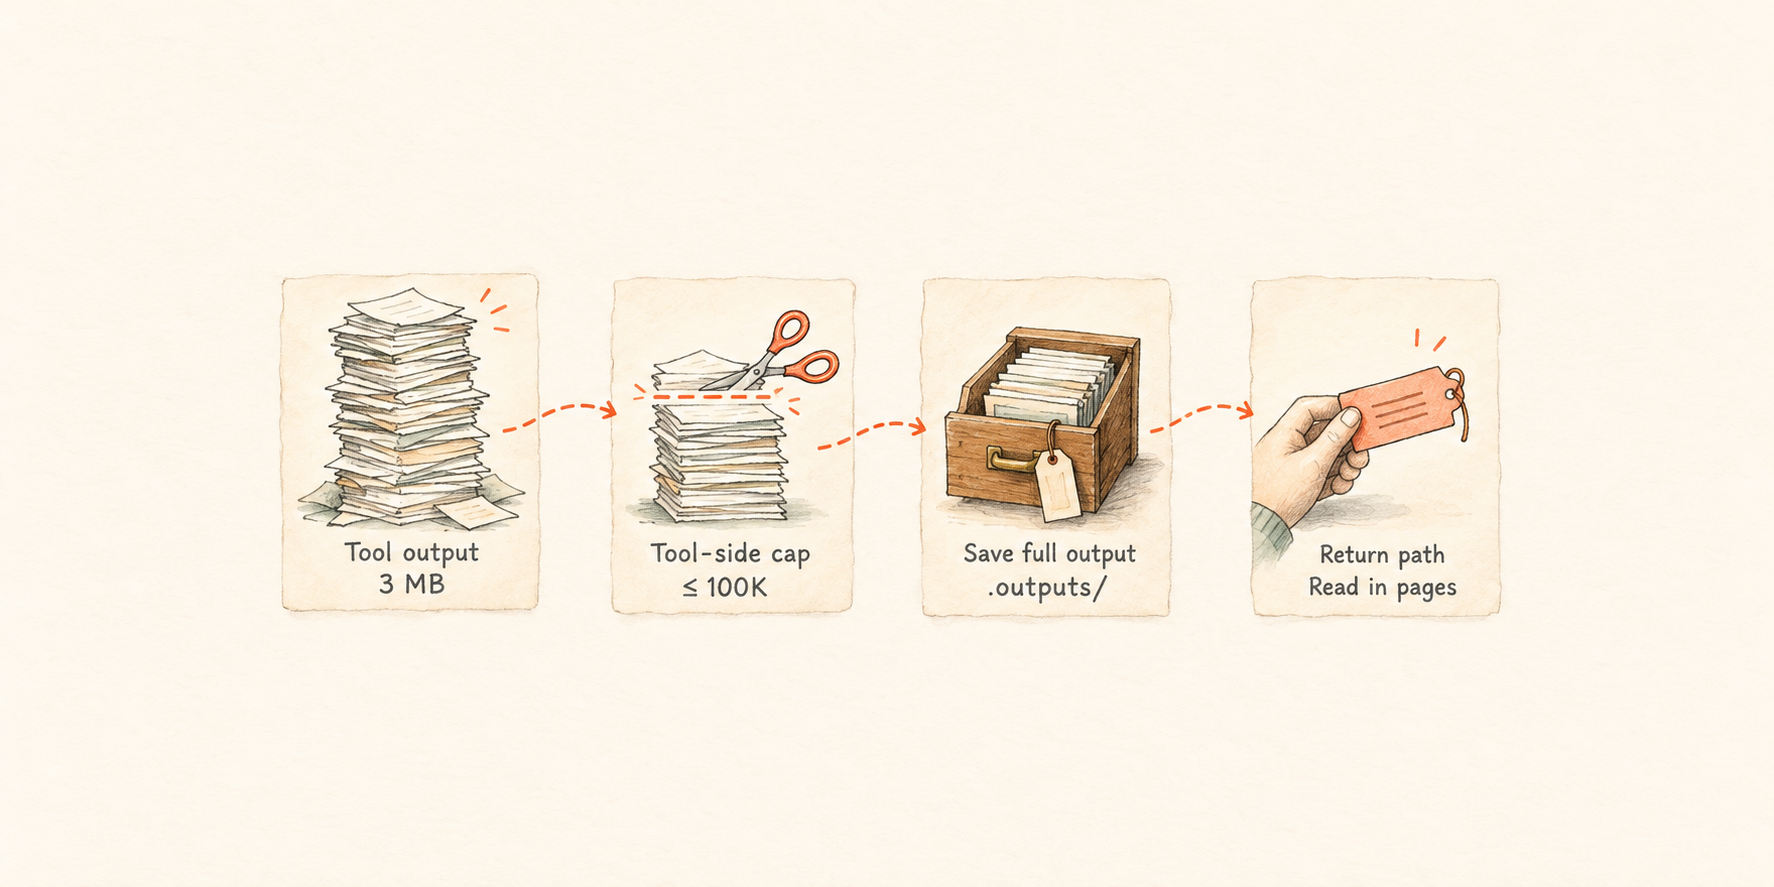
一条输出的旅程:截断、存盘、留下取货单。
这张"取货单"长这样:
{
  "result": "...前 100K 字节...",
  "truncated": true,
  "total_size": 3145728,
  "file_path": "/workspace/.outputs/xxx.txt"
}
意思是:这里是前 100K 字节的内容;结果被截断了;完整内容一共约 3MB;完整版存在这个路径。
围绕这张取货单,有三个设计相互配合。
取货单是"表格",不是一段话
是否截断、总大小、文件路径,都是单独的字段,而不是写在一段描述文字里。模型可以直接照着字段行动,系统里的其他环节也不用去解析文字就能拿来用。
我们甚至专门写了一个反向测试:如果工具输出的正文里恰好出现了一段"完整内容在某某路径"的文字(比如日志里本来就有这样一句话,或者有人故意伪造),系统会把它当作不可信的内容处理。路径只认那个专门的字段。
“怎么取货"写在取货单上
截断标记里会直接写明:完整内容存在哪里,可以用 grep、head、jq、cut 这类文本工具去处理它,或者用读文件工具一段一段地翻。
而在给模型的整体说明(系统提示)里,关于这件事一个字都没写。模型只在"看到截断的那一刻"才拿到"接下来怎么办"的指引。
道理是:和某个特定情境绑定的指引,就让它跟着那个情境出现,而不是一股脑堆在整体说明里。这条原则在后面讲授权的那篇还会再出现一次。
连"取货"的工具本身也有上限
读文件工具支持"从第几行开始、读多少行"的分页,但它自己的输出同样不会超过 100K。
如果没有这个上限,模型只要一次要求"读一百万行”,就能把刚才存出去的整个文件原样拉回对话记录里——前面的截断就白做了。对输出的克制,必须一直贯彻到"取回"这条路上,否则每一道防线都可能成为另一道防线的漏洞。
一个诚实的例外
在少数环境里,完整内容可能没能成功存盘。这时截断标记会如实告诉模型:“完整输出没有保存,无法找回,请缩小范围重新执行。“不假装有路径,更不编一个出来。
每个工具都自觉还不够:再加一道"总量闸”
每个工具都管好自己了,还有一个漏洞:模型一轮可以同时发起十几个工具调用。每个都顶着 100K 回来,一轮就是一 MB 多。
所以系统层面的那道关卡还是需要的,但它管的是总量,而不是单条:一轮里新产生的所有工具结果,加起来超过 200K 字节时,就对超出的部分做降级处理——保留开头约 2K 的可读内容,剩下的换成一句"已省略 N 字节,完整内容在某某路径”。
这道闸有几条清晰的边界:
- 只管这一轮新来的结果,对话记录里更早的内容一律不动;
- 永远开启,但永远不阻塞模型的下一步;
- 优先复用已有的取货单:如果结果里已经带着文件路径,就直接用;没有才当场存一份。文件名根据内容生成,同样的内容永远对应同一个路径,存多少次结果都一样;
- 存盘最多等 3 秒:这是每一轮都要经过的关键路径,万一写盘卡住了,宁可退一步只留一个"内容已省略"的标记,也不能拖住整轮对话。
命令行工具的两个特殊处理
在所有工具里,执行命令行(bash)的工具输出最大,它有两点值得单独说。
在"执行的那一侧"就截断
命令不一定在我们的服务器上跑。有些客户选择让命令在他们自己的机器上执行(这种部署方式叫 BYOC,下一篇会详细讲),这时截断就发生在客户那一侧,我们的平台只拿到截断后的预览和存盘路径。
命令在我们的云端沙箱里跑时,由我们自己截断。截法是:写满 100K 之后,多出来的字节在写入的那一刻就直接丢弃,而不是先把完整输出全部收下来、再切一刀。因为要防的不只是对话记录膨胀,还有把一整份巨大的输出先在服务器内存里装一遍。
另外,正常输出(stdout)和错误输出(stderr)是两条独立的流,各自截断、各自存盘。这样错误信息就不会被海量的正常输出挤掉。
后台任务不截断
如果命令是在后台运行的(比如一个持续输出日志的长任务),它的完整输出会实时写进文件,随时都可以去读。不过,文件一旦长到 50MB,任务就会被终止。
截断保护的是模型的对话窗口,不是磁盘;磁盘有磁盘自己的那道闸。
这条约定背后的分工
回头看,这一整套设计其实在回答一个问题:工具的输出,到底该由谁来管?
我们的答案是:工具自己。
- 模型是输出的使用者,不是管理者。它不知道一次搜索会返回多少行,也没法在结果送到之前反悔;
- 系统层负责总量和结构上的规则(配对、上限、重复执行结果一致),但它不懂内容;
- 只有工具自己知道:哪部分必须留、留多少、剩下的放哪儿、怎么告诉使用者去取。
这种分工还体现在工具之间的"互相劝退"上。命令行工具的说明里明确写着:读文件和搜索,请优先用专门的读文件、找文件、搜索工具,而不是 cat、head、tail 这些命令——因为专门的工具才能正确处理路径、分页和输出上限。搜索工具的参数说明里也直接写着:限制返回条数的参数,请"大胆地用小值"。
工具的说明文字,本身也是管理输出的一部分。
小结
- 工具的输出可能非常大,原样放进对话记录又贵又浪费;
- 模型事先不知道输出多大,统一的一刀又不懂内容,所以由每个工具自己把输出控制在 100K 字节以内;
- 截断不是扔掉:完整内容存成文件,模型拿到一张写着路径和总大小的"取货单",需要时按图索骥;
- “怎么取"的指引跟着截断标记出现;取货的工具本身也有上限;存不了盘就如实说;
- 系统层再加一道每轮 200K 的总量闸,防止十几个工具同时满载而归;
- 命令行工具在执行那一侧就截断,正常输出和错误输出分开处理;后台任务完整写文件,但有 50MB 的磁盘上限。
下一篇换个大话题:agent 的"大脑"应该放在哪里——我们的云端,还是客户自己的环境里?我们的答案是:跟着入口走。
这是 “Flashduty AI SRE( https://www.flashduty.com )技术揭秘” 系列的第八篇。我们在做一个专注 SRE 领域、帮你做故障根因分析的 AI Agent 产品,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。