旧清单躺在一边,读者直接翻书架。
Flashduty AI SRE( https://www.flashduty.com ) 是一个专注 SRE 领域、帮你做故障根因分析、日常运维工作的 AI Agent 产品,注册即可免费试用。这是系列文章《Flashduty AI SRE 技术揭秘》第 7 篇,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。
先说说"知识包"是什么
一个 AI agent 要帮团队排查故障,光有通用知识是不够的。它得知道这个团队的系统长什么样、出事时按什么流程处理、过去踩过哪些坑。
所以我们的平台支持知识包:团队把操作手册(SOP)、架构说明、历史故障复盘这些资料整理成一批文件放进来。每次 agent 开始一段新对话时,系统会先给它一段开场说明(我们叫 manifest),告诉它"你手边有哪些知识可以用"。
就像新同事入职第一天,领导递给他一张纸:“公司的文档都在这儿,有这些,那些。”
这篇要讲的,是这张纸上曾经有、后来被我们整个删掉的一样东西:一份完整的文件目录。
一份目录,看起来百利无一害
最早的开场说明里,有一份逐行列出的完整目录:这次对话能用哪几个知识包,每个包里有哪些文件。
动机很正当:模型不用猜手边有什么,看一眼目录就知道能读什么。谁会反对给新同事一份目录呢?
问题出在这份目录放的位置上。
目录和"缓存"撞车了
第 5 篇讲过,大模型每次回答前都要把完整的对话记录重新读一遍,而服务商提供一种叫 prompt cache(提示缓存) 的省钱机制:如果这次发过去的内容,开头部分和上次一模一样,那这部分就按很便宜的"缓存价"计费。条件是必须从第一个字开始、逐字节一致,开头只要变了一个字节,后面所有内容都得按全价重读。
开场说明恰好就在请求的最开头。为了保住缓存,我们对这一段格外小心:每一轮对话开始时,把它"冻结"下来,整轮都原样复用;只有到了下一轮开头,发现内容确实变了,才重新冻结一次。而每重新冻结一次,就意味着一次缓存失效、一次全价重读。
把这两件事放在一起,矛盾就出来了:
- 目录的内容取决于有哪些文件;
- 而文件是会变的。
同事在控制台改了一个知识包、加了一份新复盘,所有正在进行的对话里,目录都得跟着变;目录一变,开头就变了,缓存当场作废。知识库里每增、删、改一个文件,所有正在进行的对话都要陪着付一次全价。
两条路,都走不通
路线一:目录冻住不动,接受它会过时
目录留在开头不更新,文件在底下照常变化。结果就是:新加的文件不在目录上,已经删掉的文件还列着。
这比没有目录更糟。
没有目录时,模型知道自己不知道,会主动去翻;有一份过时的目录,模型会以为自己知道——它会照着目录去读一个早已不存在的文件,或者压根不知道新文件的存在。
就像那位新同事拿着一份半年前的文档清单,按图索骥,处处碰壁,还不知道该去问谁。错误的信息比缺失的信息危害更大,因为它会被当真。
路线二:保证目录永远最新,每次变化都更新
目录永远准确,代价是缓存永远热不起来。知识包是团队多人协作维护的,改动很频繁。这条路说白了就是:为了目录准确,放弃整个开头的缓存。
在这个位置上,“冻住省钱"和"保持新鲜"只能二选一。我们哪个都没选,走了第三条路:把目录从开场说明里拿掉。
开场说明现在只剩一段"不会过期"的指引
现在的开场说明里,没有任何逐文件的列表,只有一段固定不变的说明,大意是:
知识文件都在
knowledge/目录下,请像浏览代码仓库一样,用ls(列目录)、glob(按模式找文件)、grep(搜内容)自己去发现。每个知识领域都有一份DUTY.md,它是精心整理过的入口,但不是完整清单——可能还有它没提到的文件。用ls/glob拿到的路径,请原样传给read去读,不要自己猜,也不要缩写。
这段话里每一句都有讲究:
- “DUTY.md 不是完整清单”,是在管理模型的预期。它必须知道入口之外还有东西,才会主动去翻。
- “路径原样传”,是踩过坑才加上的。早期的说明里出现过一次绝对路径,和模型在工作区里实际看到的路径形式对不上。模型被搞糊涂了,只好开始用
glob **/*把所有文件扫一遍。给模型写说明,必须站在它的视角写,连路径长什么样都要对得上。
拿掉目录之后的好处是可以验证的:开场说明的内容,现在只会随着"有哪些知识领域"和 DUTY.md 的内容而变化。普通文件的增删改,再也不会改动开场说明的一个字节,缓存命中率不再受别人编辑文档的影响。
我们写了一个测试专门守住这一点:增加、删除、修改任意一个非 DUTY 文件,生成出来的开场说明必须和之前逐字节相同。上一篇结尾说"规则应该是一个会变红的测试”,这就是一个例子。
唯一的例外:DUTY.md
DUTY.md 的内容会直接嵌进开场说明里(上限 32KB,超出部分截掉,并附上一句"请去读完整文件"的提示)。所以它一变,开头就要重新冻结一次,缓存也会失效一次。
这是有意保留的。DUTY.md 是团队精心整理的入口,是"动手之前必须知道"的那类信息,值得为它付一次缓存的代价;普通文件则不值得。
顺带删掉的两样东西
删目录的那次改动,还顺手清理掉了两样东西。它们值得单独说说,因为很能说明"删功能"该怎么删。
一套为一句话而存在的校验机制
有目录的时候,开场说明里有一句话告诉模型:“所有知识文件都已经放到磁盘上了。“为了保证这句话是真的,背后有一整套校验机制:判断是不是全部文件都已落盘、落盘后还要再核对一遍。
这句话删掉之后,那套机制当天就没了用处,于是一并删除。一个功能的附属机制,不要以"说不定以后有用"为由留着——它服务的前提已经不存在了,留下来只会让下一个维护的人对着一堆代码考古。
开头里的"今天几号”
开场说明里原本有一行"当前日期:……"。问题是,午夜一过,日期就变了,开头的内容也就变了,冻结随之失效——每天凌晨,所有对话的缓存准时集体作废一次。
后来我们把日期挪到了请求的末尾:一段只在这次请求里附带、不属于"开头"的小提示(我们叫尾部 reminder)。开头从此不再随日历变化。
“容易变的信息一律放在末尾”,现在已经是我们往上下文里加任何内容时的默认检查项。
目录并没有消失,只是搬到了该在的地方
这里需要澄清一下,免得误解:文件目录这份数据并没有被消灭。
在负责准备运行环境的那一侧,系统依然维护着一份逐文件的清单,每个文件还带着校验值。机器靠它来对账:哪些文件该放到磁盘上、哪些已经过时该清理、哪些是新来的。逐文件对账是机器的活儿,在机器这一层,这份清单是必需的。
我们删掉的,只是"把这份清单抄一份给模型看"这个做法。给模型的东西,从一份数据换成了一种能力:ls、glob、grep、read。文件系统里的情况永远是最新的,模型翻到什么就是什么,根本不存在"过期"一说。就算读到一个还没放到磁盘上的文件也不要紧,read 工具会当场从存储里取下来、放好再返回——发现即加载。
文件变了,会有人告诉它
这不等于对变化不闻不问。如果某个文件在对话进行中真的被改了,系统会在请求末尾附上一句提醒:“这几个文件在对话之外被修改了,磁盘上已经是新版本,如果你之前读过,请别依赖记忆,重新读一遍。“同样只放在末尾,不碰开头的缓存。
这个提醒的原则是宁可漏报,不可误报:
- 新增的文件从不提醒。发现新文件是
ls和DUTY.md入口该干的事; - 只有"你读过的东西变了或者没了”,才值得专门说一句。
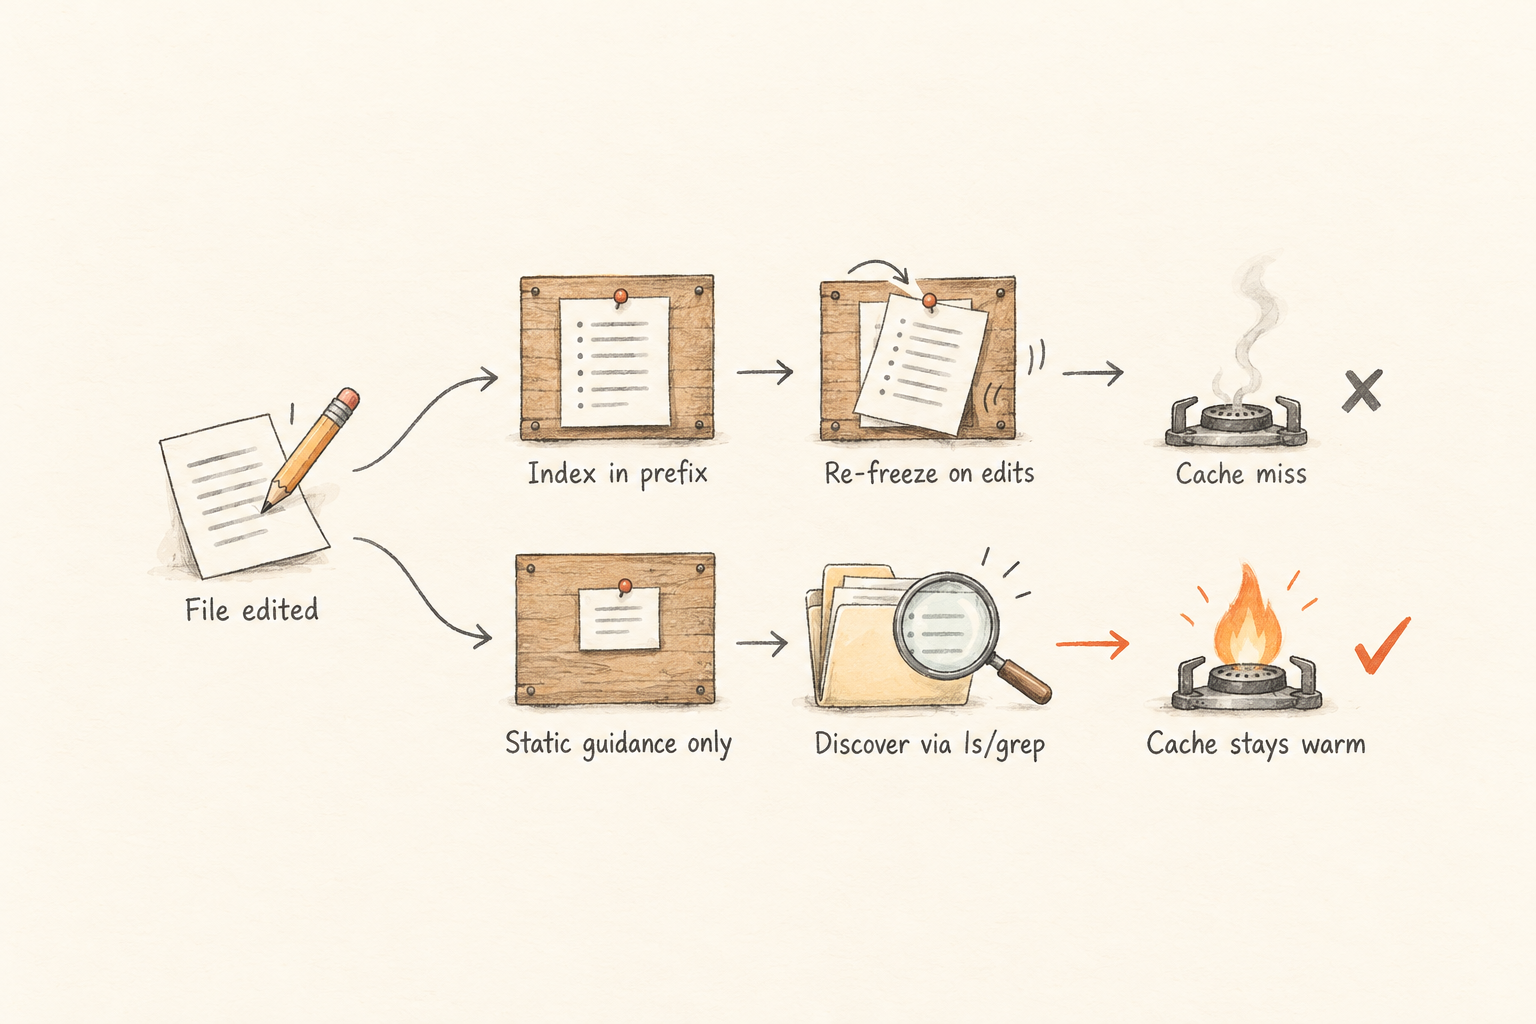
上:目录放在开头,文件一变缓存就作废;下:开头只放固定的指引,发现交给工具,缓存稳定。
这条原则不只适用于知识包
凡是"把一份索引喂给大模型"的系统,迟早都会撞上同一堵墙:工具列表、文档库的目录页、数据字典……索引越详细、变得越频繁,开头的缓存就越不稳定。两者天然是此消彼长的关系。
我们的答案是:
- 开头只放不会过期的指引;
- 把"发现"变成模型自己的能力,而不是喂给它的数据;
- 索引照样存在——在数据库里、在文件系统里、在机器对账的清单里——只是不在提示的开头。
小结
这篇讲的是一次"做减法”:
- 给模型的文件目录放在请求开头,文件一变,缓存就作废;
- 目录冻住不更新会过时,而过时的信息比没有信息更糟,因为它会被当真;
- 我们把目录换成一段固定的指引,让模型自己用工具去翻,开头从此不再随文件变化;
- 顺手删掉了为那句"文件已就绪"服务的校验机制,并把日期这类每天都变的信息挪到了末尾;
- 清单本身没有消失,只是留在了机器需要它的地方;文件变化则用末尾的提醒来通知。
下一篇继续讲工具这一侧:一次 grep 返回了几 MB 的输出怎么办?我们的约定是每个工具自己把输出截到 100K 以内,大的内容写进文件,只把路径交给模型。
这是 “Flashduty AI SRE( https://www.flashduty.com )技术揭秘” 系列的第七篇。我们在做一个专注 SRE 领域、帮你做故障根因分析的 AI Agent 产品,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。