书可以拿走,位置得留证。
Flashduty AI SRE( https://www.flashduty.com ) 是一个专注 SRE 领域、帮你做故障根因分析、日常运维工作的 AI Agent 产品,注册即可免费试用。这是系列文章《Flashduty AI SRE 技术揭秘》第 6 篇,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。
先回顾一下:AI 的"记忆"是怎么来的
上一篇我们打过一个比方:大模型像一位每次回答前都要把全部聊天记录从头读一遍的助理。它本身记不住上一轮说了什么,所谓"记忆",就是每一轮都把完整记录重新发给它。
记录越聊越长,总会顶到模型一次能读的上限(业内叫"上下文窗口")。为此我们设计了压缩:在快要顶到上限之前,提前让模型把前面的对话总结成一份摘要,替换掉原文。这是一件有计划的事——提前预判、从容执行、结果正式存档。
但计划总有失手的时候。这篇讲的就是那个没有计划的时刻。
当请求被一口回绝
一次请求发给模型服务商,对方直接拒收,返回的错误是 context_length_exceeded——“内容超长,读不下”。
怎么会这样?明明有压缩在前面把关。原因在于,“现在记录有多长"这个数字,有一部分是估出来的。上一篇讲过,我们以服务商最近一次告诉我们的真实数字为基准,只对之后新增的内容做估算。平时这点误差无关紧要,可如果新增的恰好是一批异常庞大的工具输出,估算就会明显偏小——等服务商告诉你装不下的时候,已经装不下了。
这时候没时间慢慢写摘要了,必须当场把请求"砍小”,立刻重发。我们把这个动作叫做 EmergencyTrim(紧急裁剪)。
砍什么?工具输出
要理解该砍什么,先说说一个 AI agent 的对话记录里都有些什么。
agent 和普通聊天机器人最大的区别,是它会动手:查日志、跑命令、搜代码。每次动手,记录里都会多出两条:
- 一条是模型说"我要调用某个工具,参数是这些"——我们叫它工具调用;
- 一条是工具执行完返回的结果——我们叫它工具结果。
人和模型说的话通常就几句,工具结果却可能非常庞大:一次 grep 搜索的输出,可能抵得上几百条普通消息。所以记录里最占地方的,永远是工具结果。
砍什么很明显。怎么砍,才是这篇真正要讲的。
直觉做法:整条删掉——然后请求再也发不出去了
最直接的想法是:把最老的那条工具结果从记录里整条删掉。空间腾出来了,记录看上去也"干净"了。
我们真这么试过。重发,服务商返回 400 错误,请求不合法。再重发,还是 400。
问题出在"调用"和"结果"的配对关系上。
打个比方:工具调用像一张寄出去的挂号信,工具结果是对应的回执,两者靠同一个编号对上。模型一次还可能同时寄出好几封信,每封都要有自己的回执。主流模型服务商在收到请求时,都会检查这套编号是否一一对应。如果某封信寄出去了,却找不到它的回执——这封信就成了"孤儿",服务商会直接拒绝整个请求。
于是,一个本来为"请求发不出去"准备的自救措施,反而把问题变得更糟:
- 原来是"太长了"——砍一砍还有救;
- 现在是"格式不合法"——不管怎么重试,这个会话都没救了。
安全网本身变成了一个必然失败的陷阱。
我们的做法:不删记录,原地换一块"代书板"
紧急裁剪最终的选择是:一条记录都不删,一个位置都不动,只把那条工具结果的内容替换成一段简短的说明文字。
这段说明文字的原文是这样的:
[removed by emergency context trim to recover from a
context-length-exceeded error; re-run the tool if the
result is still needed]
翻译过来就是:“这条内容因为上下文超长被紧急裁掉了;如果还需要这份结果,请重新运行一次工具。“注意,它既是一个标记,也是写给模型看的一句提示:告诉它这里原本有东西,需要的话可以自己再取一次。
替换时,只动"结果内容"这一个地方。配对用的编号、工具名字都原封不动,记录的条数和顺序也完全不变。在服务商看来,每封信都有回执,配对完好无损——只是其中一张回执上的内容变成了一句短话。空间腾出来了,结构没有被破坏。
这就像图书馆里的"代书板”:书被借走了,原来的位置插上一块木牌,写着"此书已借出”。书架的排列一点没变,任何人来查,这个位置仍然"有东西",只是告诉你内容暂时不在这儿。
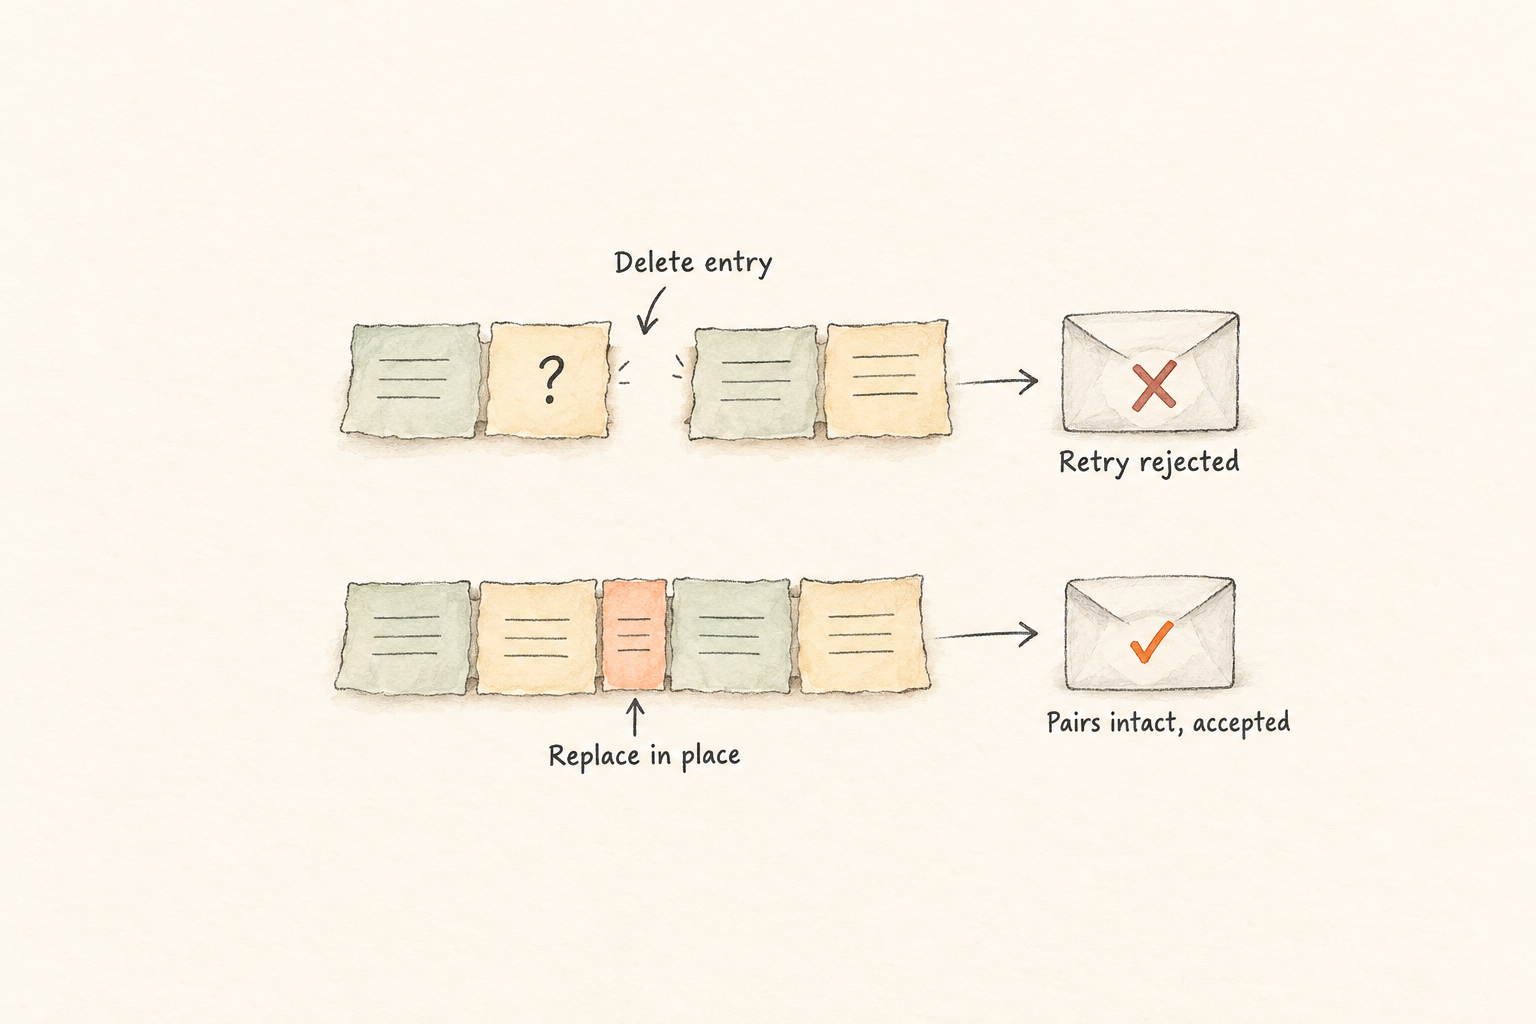
上:整条删除,配对断裂,怎么重试都失败;下:原地替换,结构完好,请求顺利通过。
手术的几个细节
从最老的开始,够了就停
裁剪从最早的那条工具结果开始,一条一条往后替换。每替换一条,就重新估算一次总长度,一旦降到目标以下就立刻停手。这样能尽量多保住最近的工具输出——毕竟越新的结果,对当前的推理越有用。
目标值定为当前估算长度的一半。之所以砍得比"刚好装下"更多,是为了给接下来的对话留出增长空间,避免下一轮马上又撞线。
没有"最近几条不许动"的保护区
我们刻意没有设置"最近 N 条结果不能裁"的保护规则。极端情况下,裁剪可以把所有工具结果都替换掉——测试里专门有这个场景。
这是有意为之。紧急裁剪是超长之后的最后一道防线,走到这一步,让这次请求能发出去,比保住任何一条旧输出都重要。真需要那份数据,模型可以按照说明文字的提示,重新运行一次工具。
反复触发也不会出错
那段说明文字足够长、足够独特,真实的工具输出不可能碰巧长成这样。所以系统一眼就能认出"这条已经被裁过了",再遇到时直接跳过。
即使同一段记录反复超长、反复裁剪,每次也只是在上一次的基础上继续往后推进,不会重复计算,也不会出错。
只改这一次请求,不动存档
这是紧急裁剪和压缩最本质的区别,值得多说几句。
紧急裁剪改的只是"这一次要发出去的请求",数据库里存的原始记录一个字都没动。也就是说,下一轮重新从数据库加载记录时,被裁掉的原文会回来。
为什么不顺手把裁剪结果存下来,省得下次再裁?因为紧急裁剪是"丢弃式"的:它没有写摘要,被裁掉的内容就是被扔掉了。如果存进数据库,就等于永久销毁了这段历史。一个在事故现场仓促出手的应急措施,没有资格做这种不可挽回的决定。
真正有资格"丢掉原文"的,只有正式的压缩——因为它留下了摘要,并且清楚记录了从哪里到哪里被压缩了。
说明文字里那句"需要的话请重新运行工具",正好和"原文还在数据库里"这个设计互相配合:模型随时可以把真实数据找回来。
重试不打乱节奏
裁剪完成后,系统立刻向同一个服务商原地重试:
- 不等待、不退避;
- 不切换到备用服务商;
- 不把这次失败记到服务商的"健康度"上。
原因很简单:这个错误说明的是"请求太大",而不是"服务商出了故障"。换一家服务商,请求还是一样大。
如果裁完还是超长,就再裁一批,再试。直到没有任何东西可以再裁,才把最初的错误交还给上层处理。
更大的原则:对话记录不是日志,而是数据结构
这个小机制背后,是一条我们反复踩坑才总结出来的原则:agent 的对话记录不是日志,而是一个有内部约束的数据结构。
日志可以随便删一行,每一行都是独立的;对话记录不行。条目之间有配对、有顺序、有因果关系,删掉一条,可能让另一条变得"不合法"。
这条约束其实贯穿了整个系列:
- 第 3 篇讲中断:要等一批工具调用都拿到结果再停,就是为了不留下"孤儿"调用;
- 第 5 篇讲压缩:选择切点时,不允许把一对调用和结果拆到两边;
- 这一篇讲紧急裁剪:干脆一条记录都不删。
三个机制解决的是三个不同的问题,守护的却是同一条规则。
为了让这条规则不只是停留在文档里,我们在测试里放了一个专门的检查器:扫描完整的对话记录,只要发现任何一个找不到对应结果的工具调用,测试就直接失败。规则不应该只是一句提醒,它应该是一个会变红的测试。
小结
这篇讲的是一次"急救手术":请求因为超长被拒,必须当场把它砍小。
几个关键选择:
- 砍的是最占地方的工具结果,从最老的开始,降到一半就停;
- 不删记录,只替换内容,保住"调用—结果"的配对,否则请求会彻底变成非法;
- 说明文字既是标记,也是给模型的提示,需要时可以重新取数据;
- 只改这一次请求,不动数据库里的原文,永久丢弃的权力只交给正式的压缩;
- 原地重试同一个服务商,因为问题出在请求大小,而不是服务商本身。
下一篇换个话题,聊聊"该往 agent 的上下文里放什么":我们曾经想在知识包的清单里放一份权威文件列表,最后整个删掉了——因为过期的上下文,比没有上下文更糟。
这是 “Flashduty AI SRE( https://www.flashduty.com )技术揭秘” 系列的第六篇。我们在做一个专注 SRE 领域、帮你做故障根因分析的 AI Agent 产品,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。